ARTICLE / 安全
停机命令失败之后:你以为停了,它还在跑
一台 Intel Mac 上,openclaw gateway stop 和 openclaw gateway stop --force 都返回同一个错误:
报告者是在 Terminal.app 里从 Spotlight 直接启动的登录 shell 里执行的,没有继承任何服务标记。命令给出的那条建议——换个独立终端重试——他本来就已经满足。--force 的文档写的是「Allow stop from a non-interactive shell」,它同样没绕过检查。
先把性质说清楚:这是产品自身进程自省层的缺陷,导致停机请求被拒绝,服务照旧在跑。它不涉及入侵,也没有恶意驻留。问题落在运维侧——需要停的时候停不掉,随后的处置动作全部建立在错误的前提下。
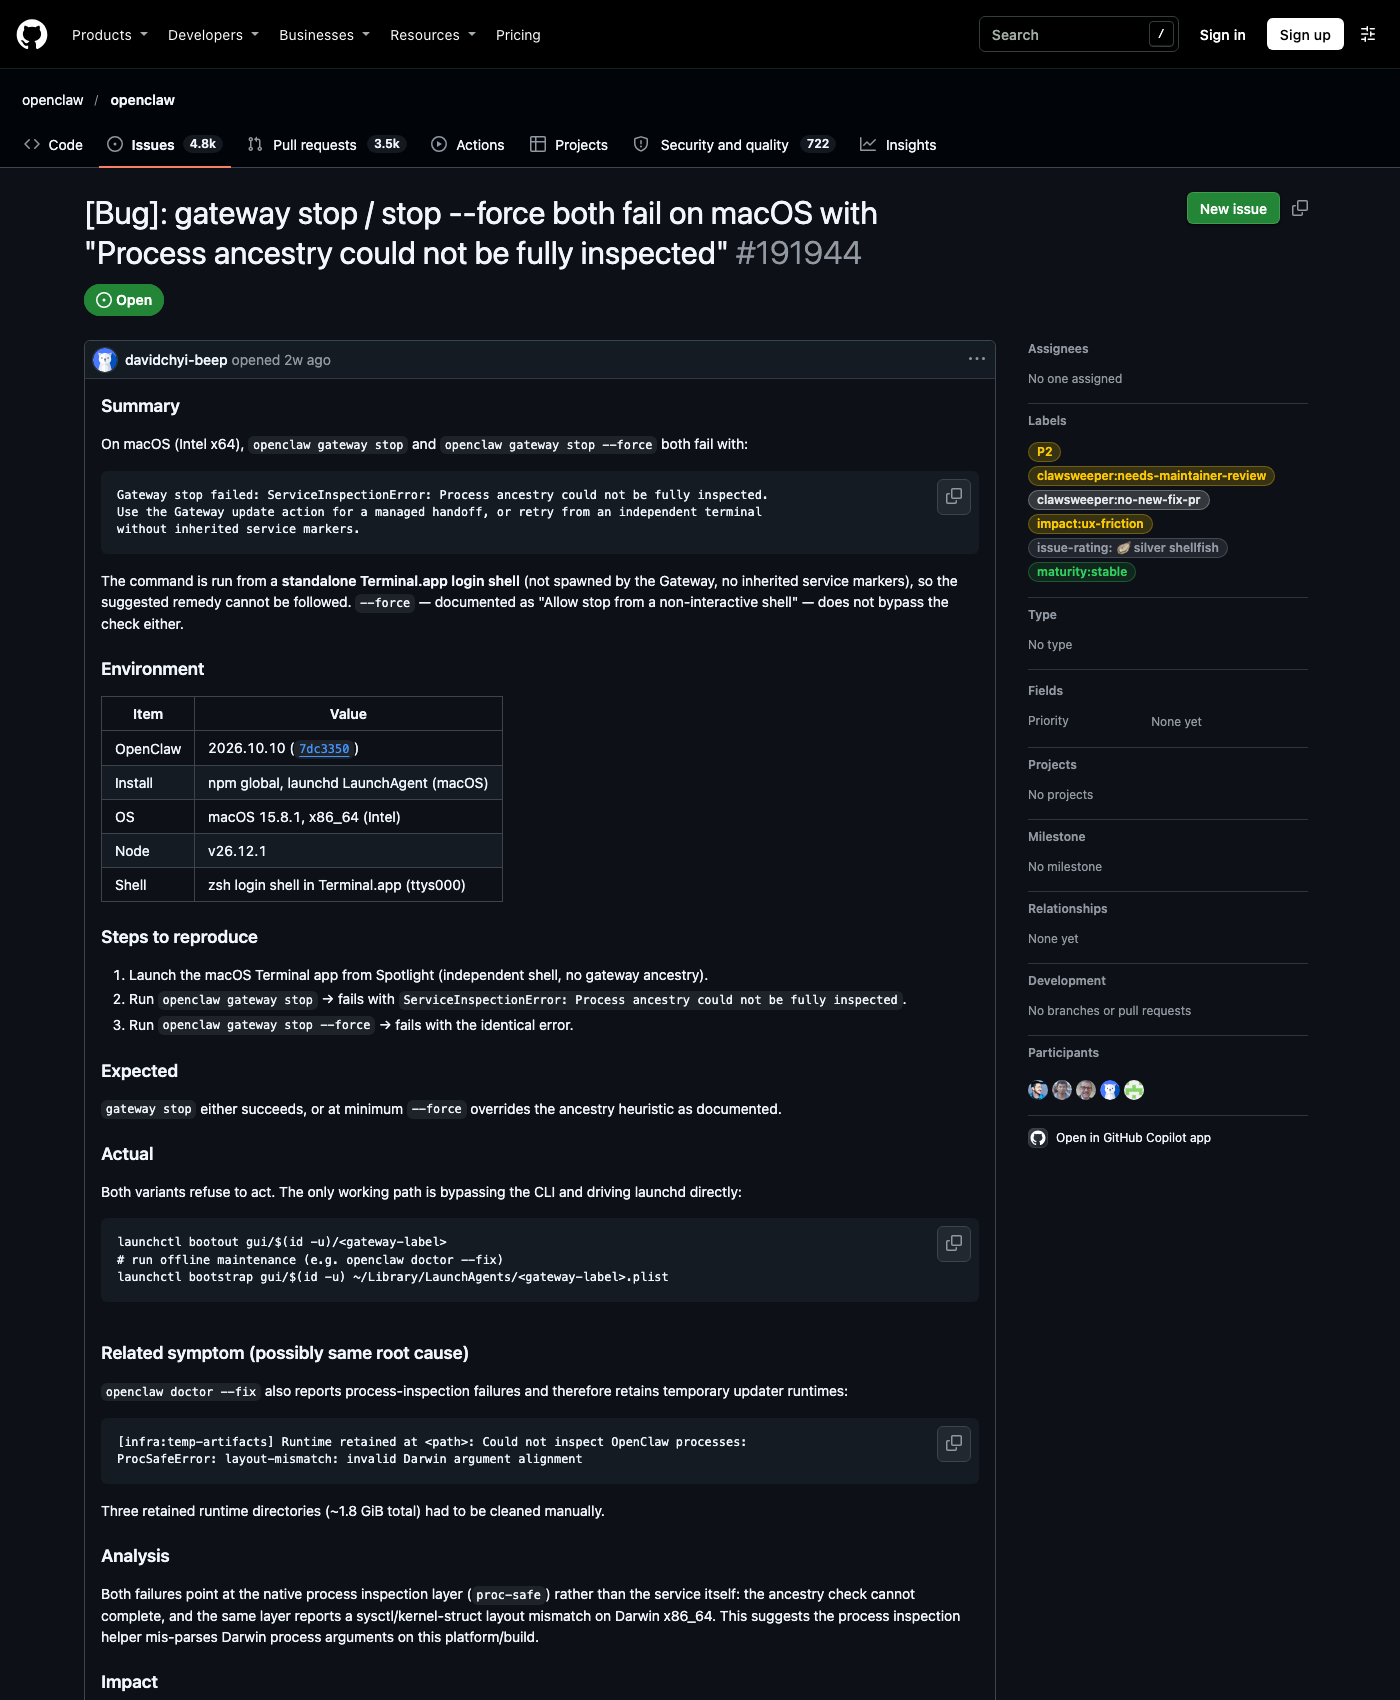 来源:GitHub openclaw/openclaw issue #191944 页面,github.com,截取日期 2026-11-14
一个停机命令为什么这么写
从错误信息能看出实现思路:它先检查进程族谱,确认要停的那个进程确实由本服务拉起,再动手。这个设计是为了防止误杀——在共享机器上,gateway stop 不该杀掉别的会话里的同名进程。
代价是:一旦族谱检查本身失败,停机就变成了不可能完成的操作。检查失败的常见原因是操作系统层面的进程信息读取异常,不是使用者操作错误。于是保护机制在最需要它的时候把控制面锁住了。
这个案例里唯一的可行路径是绕开 CLI,直接驱动 launchd:
命令本身不复杂,但它意味着使用者必须知道服务是 launchd 托管的、label 是什么、plist 在哪。应急的时候现查这些,是最不该花时间的时刻。
应急响应里最怕「状态未知」
停机失败的危害不在命令报错,在报错之后的三种误判。
第一种是把失败当成功。脚本里 || true、或者只看最后一行输出,事故现场就成了灰色地带——你以为进程没了,取证时却发现内存里的状态还在被改写。
第二种是重复启动。控制面说停不掉,人的直觉是再起一个试试,结果是两个实例同时打开同一个状态库。状态库不一致比停机失败难处理得多。
第三种是绕开后失去原来的保护。手工 launchctl 能解决问题,同时也跳过了产品本来要做的归属校验——在装了多个实例的机器上,这一步走错就是杀错进程。
同一份报告里的第二处信号
openclaw doctor --fix 也报进程检查失败:
因为清理前的检查过不去,它保留了升级用的临时运行时。三个目录合计约 1.8 GiB,需要人工删。
这条信号值得单独拎出来:一个「安全起见不删」的策略,在检查长期失败时会累积成磁盘问题。而磁盘压力又会影响状态库写入、日志落盘,绕回来加重下一轮不健康。它不是这次停机失败的原因,但两者指向同一个东西——依赖进程自省的逻辑,在自省不可用时全部退化成保守分支。
蓝队视角:把控制面可用性写进演练
这份报告的价值是把一个隐含假设挑明了:应急手册通常假设「我能停掉它」,很少验证。
可落地的三件事:
- 停机后做验尸,不看命令回执。回执只说明命令跑过,不说明进程没了。检查项包括进程表里是否还有目标进程、launchd 是否还持有该服务、监听端口是否释放、状态库的
-wal是否还在增长。最后一项最容易被忽略,也最能说明「其实还在写」。 - 准备一条不依赖 CLI 的停机路径,并且定期演练。命令、label、plist 路径写进手册,别等到真出事时去翻文档。
- 把「控制面命令返回错误」当成一个独立的告警类别。它和业务错误不是一回事:业务错误影响用户,控制面错误影响你处置业务错误的能力。
边界
报告环境是 OpenClaw 2026.10.10(7dc3350),npm 全局安装,launchd LaunchAgent,macOS 15.8.1、x86_64、Node v26.12.1。这份材料只覆盖了 Intel macOS 这一种组合,issue 里提到的 layout-mismatch 属于 Darwin 参数结构不匹配,是否影响 Apple Silicon 或其他版本,报告没有说明。
本文讨论的是运维与应急可用性,不涉及绕过任何产品安全机制的方法。
本文面向授权安全研究与防御建设,未经授权对任何系统实施文中技术属违法行为。
参考来源
- openclaw/openclaw issue #191944(macOS 上
gateway stop与stop --force均报 ServiceInspectionError 的报告),https://github.com/openclaw/openclaw/issues/191944 (采集日期 2026-11-14)