ARTICLE / ai
定时任务每天悄悄少跑一次,看板却还是全绿:Hermes 一条 P1 锁竞争 issue 的五个现场与四条未合补丁
定时任务每天悄悄少跑一次,看板却还是全绿
Hermes Agent #135487:一个锁超时问题,五台机器、四个补丁和一条没人合的修复线
2026 年 10 月 9 日,开源智能体项目 Hermes Agent 的仓库里多了一条 issue(编号 #135487)。报告者 mrwick1 的定时任务系统有一个怪现象:某个 cron 任务偶尔"失败",但你去看它的执行日志——空的。任务根本没开始跑。
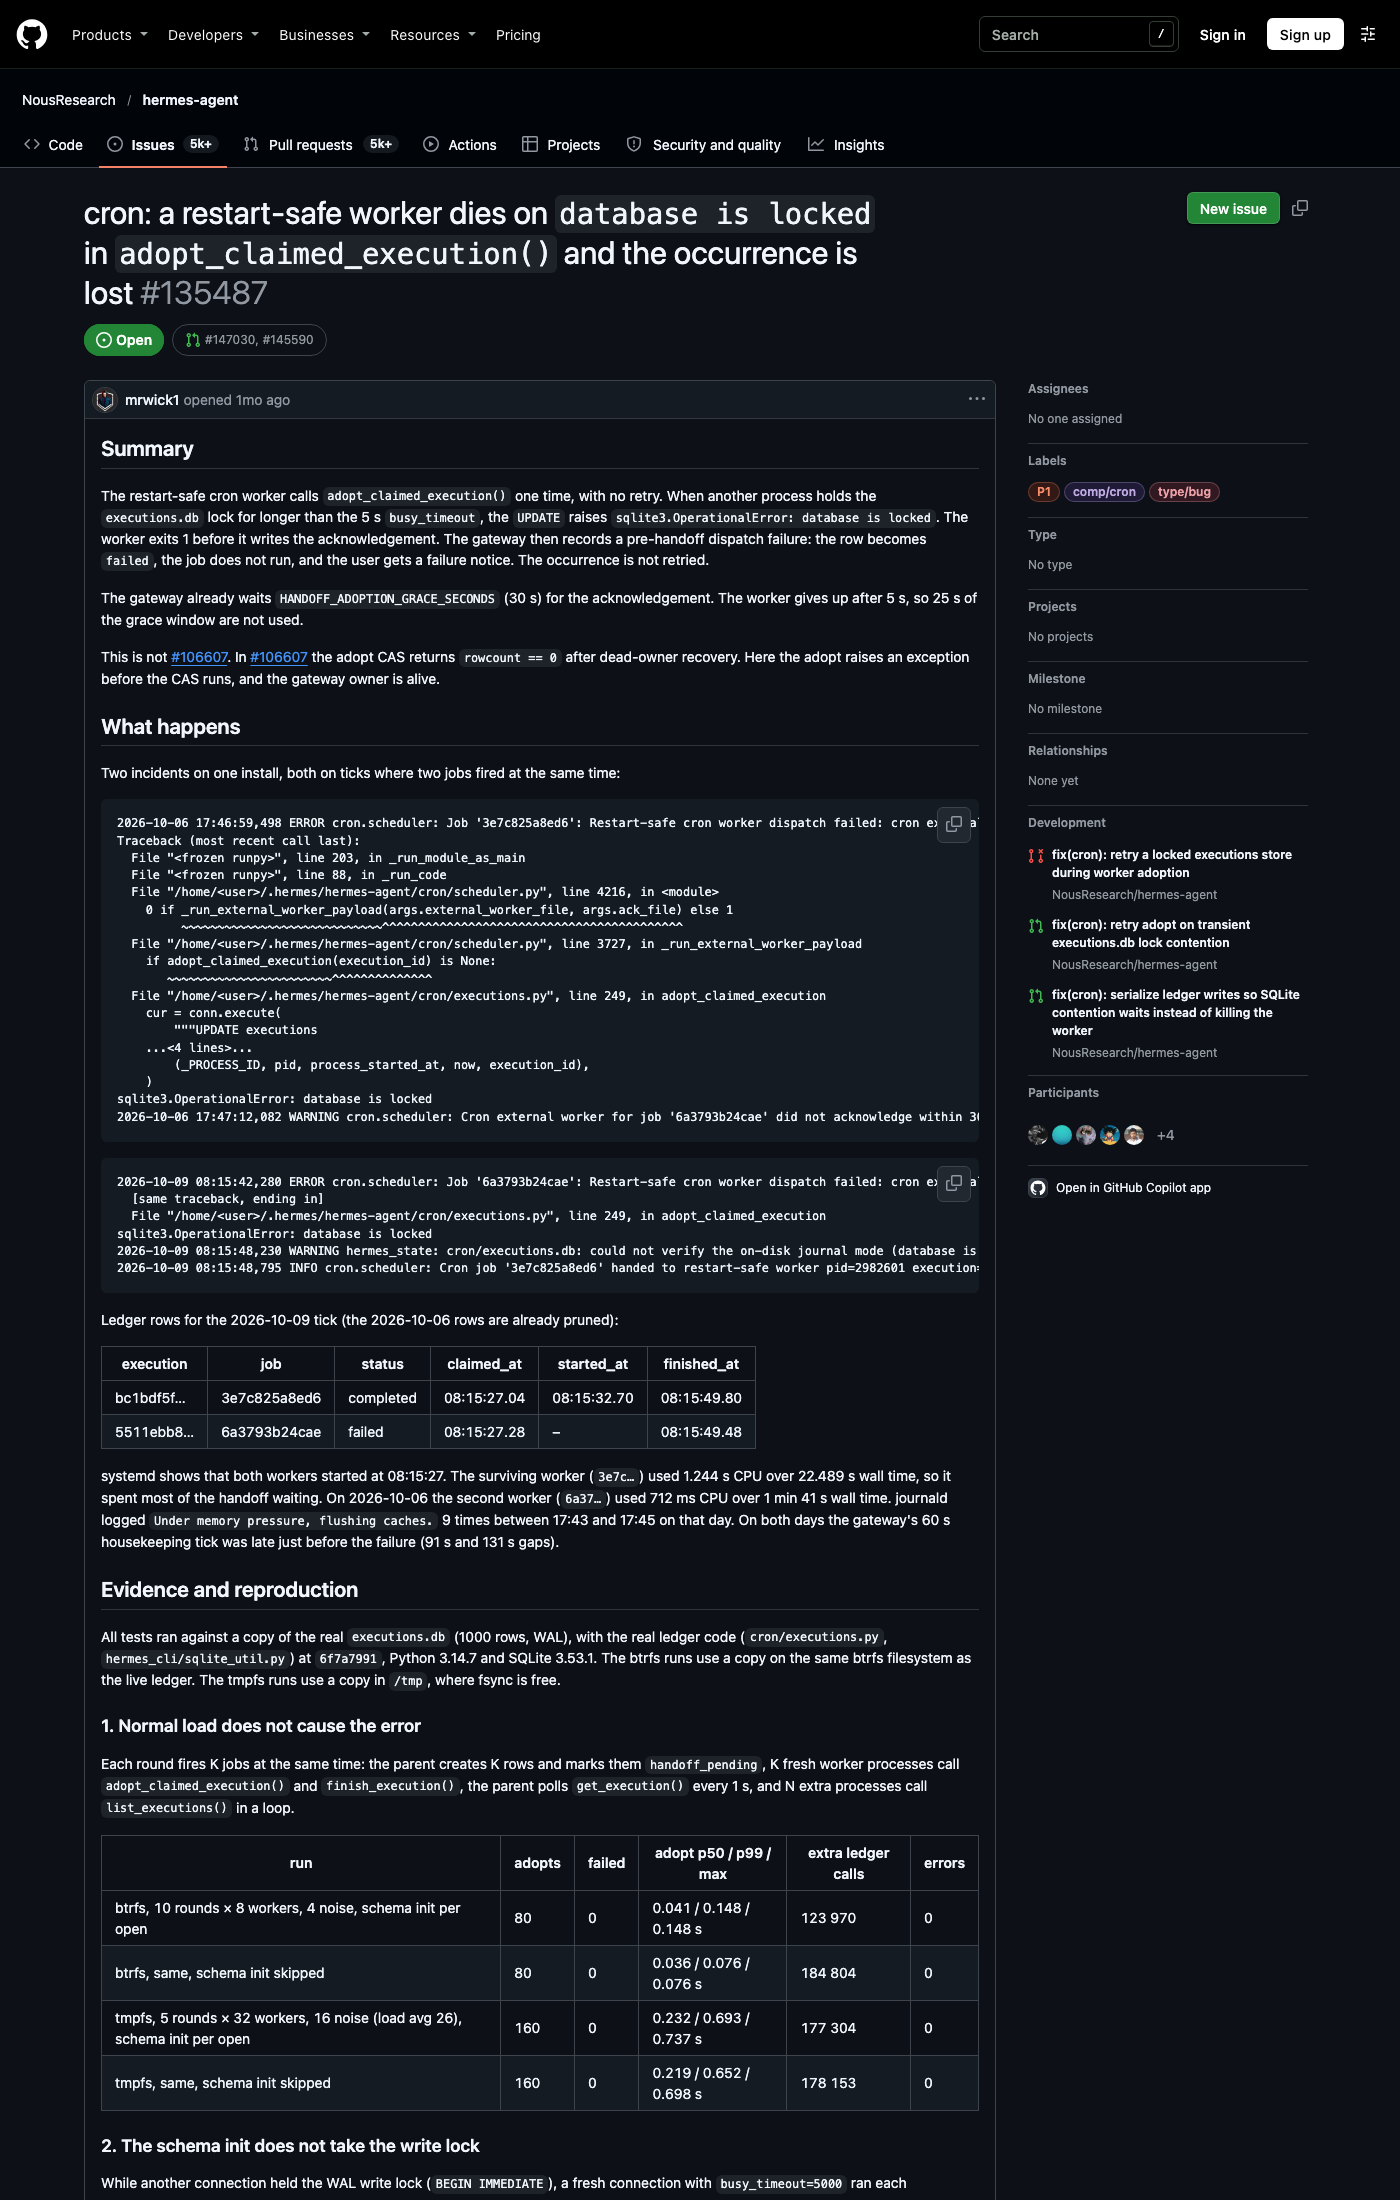
他把这条路径钉死了。网关派发一个 restart-safe worker 去执行任务,worker 要干的第一件事是在账本数据库 cron/executions.db 里把那条执行记录的状态从 claimed 改成 running,相当于举手说"这活我接了"。网关把它拦下来,等一个确认:worker 在 30 秒内完成这次状态翻转。worker 调用 adopt_claimed_execution() 只调一次,没有重试。
另一个进程占着 executions.db 的写锁超过 5 秒 busy_timeout,那条 UPDATE 抛出 sqlite3.OperationalError: database is locked。它退出前没写下确认。
网关随即记下一次移交前的派发失败:那一行变成 failed,任务没跑,用户收到一条失败通知,这次触发不会被重试。
它的超时是 5 秒。两个数字之间差了 25 秒,而这段空档没有被用上。
这条 issue 后来长成了这个仓库少见的样本:五台互不相干的机器独立复现、四份可运行的补丁、一场 Windows 原生环境上的对照压测(其他操作系统未验证),以及截至 2026 年 11 月 6 日仍然一条都没有合入主干的修复线。它值得单独拆开看,因为它暴露的不是一个 bug,是一整类基础设施病:所有用 SQLite 当多进程状态账本的自动化系统,都会在同一个位置摔倒。
报告者自己先排除了两种误判
mrwick1 的报告不是一句"程序崩了",是一组控制变量实验。他在 Arch Linux、btrfs 文件系统上复现了这条路径,环境是 v0.21.5+3698.g6f7a799(2026.9.24),Python 3.14.7 加 SQLite 3.53.1,账本文件 WAL 模式、synchronous=FULL。
他先排除了正常负载:btrfs 上 10 轮 × 8 个并发 worker,tmpfs 上 5 轮 × 32 个 worker(load avg 26),几百次接管全部成功,零错误。光有并发不会死。
接着他逐条验证:在别的连接持有 WAL 写锁时,建表、建索引、探测列这些语句全部 0 秒通过,只有那条 UPDATE 卡满 5 秒报 database is locked。schema 初始化不是持锁者。这一步排除的是"每次连接都重放建表语句拖垮性能"的直觉归因——那些 DDL 确实每次都跑,但它们拿不到写锁,也就不构成阻塞源。
持锁的窗口藏在 fsync 里。用 LD_PRELOAD 计数后测出:WAL 被删后的首次提交在写锁内做 3 次 fsync,活 WAL 下 2 次,最后一个连接关闭时的 checkpoint 再做 3 次并持有 EXCLUSIVE 锁。把单个 fsync 人为拖慢到 2.5 秒,16 个 worker 全部在 5 秒处阵亡;tmpfs 上拖到 8 秒,24 个全灭。跳过 schema 初始化不改变结果。
这台机器 fsync 的正常延迟是 p50 1.18 毫秒、最大 2.0 毫秒——一次写入大约需要 1.7 秒的 fsync 停顿,就足以让锁越过 5 秒。
也就是说,杀死定时任务的不是并发本身,是一次偶发的磁盘停顿。内存回收、文件系统回写、任何让这个存储栈慢一秒半的东西,都会把一个本来正常的账本写入变成一把攥住 5 秒以上的锁,然后把同 tick 里所有等着接活的 worker 排在门外。
报告者对自己的归因标注得很诚实:假设(未证明)——系统级 I/O 停顿(内存压力、btrfs 回写)拖慢了某个账本写入或收尾 checkpoint 里的 fsync,其他 worker 排在它后面超时。那几分钟没有 I/O 延迟历史可查。
这种"假设与证据分开摆放"的写法,是这条 issue 后面能长出高质量协作的原因。每个人都在别人的边界声明之上继续量,而不是围绕一个模糊结论吵架。
重试有效,但重试不是万能药
同样的 2.5 秒停顿,把接管包进"遇锁重试直到 30 秒"之后:16 个 worker 全部接管成功,代价是端到端耗时从 5 秒出头变成约 16 秒。
重试也有够不着的地方:每次 fsync 拖 8 秒时,持锁 writer 连续 40 秒不放,24 个接管全部在 31.3 秒处失败。重试覆盖比宽限期短的停顿,覆盖不了所有停顿。
还有更冷的一刀:两个 worker 接管成功后死在 finish_execution(),抛的是同一个错。账本的每一笔写都有同样的 5 秒暴露面。给 adopt 加重试,只是把死亡点从第一笔写挪到了后面的写——除非整个账本层的写入策略一起改。
五台机器,五种痛法
接下来两周,评论区变成了分布式现场勘查。
一位跑 7 个 profile、约 90 个定时任务的用户交来四周战报:2026-09-16 到 10-14,26 次阵亡分布在 16 个 tick 上,每次都自愈——下一个 tick 补跑,没有任务积累失败连击。
他的数据推翻了原始假设的一半:16 个失败 tick 里 11 个只有一个任务阵亡,没有任何同刻碰撞。多任务同时触发不是全部原因——宿主机上有别的写入者在那些 tick 里占着锁。这跟主贴测出的 fsync 停顿机制吻合:无关的写入者(或者收尾 checkpoint)在自己的 I/O 上卡住,孤零零的 adopt 排在它后面超时。
他还发现告警失真:一次失败在事件台账里开了行又自动核销,另一次干脆没有台账行。想数清发生频率,只能 grep 日志。
单 profile 装机的另一份现场报告更狠:他在 burst 间隙采样 /proc/locks 整整 180 秒,没抓到任何持锁超过 0.5 秒的写入者——burst 期间的持锁者至今身份不明。这位用户自己动手打了局部补丁:把整个接管事务包进最多 3 次重试,只在错误码是 SQLITE_BUSY 或 SQLITE_LOCKED 时重试,按错误码判断而不是匹配报错文本。
打补丁的窗口里零失败——包括 10 月 15/16 日的 765 次移交。
然后是他最扎手的发现:hermes update 会把本地修改 autostash 起来且不恢复——每升一次级,bug 准时回来。不打补丁时它是间歇发作,一扇 2.3 天的窗口可以完全干净。下游用户没法把这个修复带在身上,因为每次更新都会把它冲掉。这一条把问题的性质说透了:这不是"有没有人找到修法"的问题,修法好找、已被反复验证;这是修好的代码进不了主干、也留不住在本地的问题。
macOS 上的实测给出另一半图景:v0.22.2 下 100 次连接重放 403 条 schema 语句,打上每进程只初始化一次的补丁后只剩 7 条。这位报告者同样诚实:在 APFS 上量不出延迟差别(p50 45.5 毫秒对 46.1 毫秒),收益是省掉的每连接开销,不是他能演示的提速。
schema 瘦身治不了持锁失败,但它把每次写锁窗口里塞进的无用功削掉了大半——在 btrfs 上,主贴实测它把 adopt 的 p99 从 0.148 秒砍到 0.076 秒。
一台 51 任务的 Fedora 笔记本交出大样本:合盖唤醒释放约 6 小时积压,29 个认领在两分钟内落地,约 15 个 worker 进程同时挤向账本。盘点查询:started_at 为空的执行共 44 条,涉及 24 个任务,其中 39 条 status=failed、5 条 unknown。
更冷的是记账错位:派发失败路径把执行行标记成终态,却从不走到 _record_run_outcome()。jobs.json 里那个任务 last_status=“ok”、failure_streak=0,last_failure 停在一周前的一次旧失败上。监控面板读到的是绿灯,账本底下躺着 failed。last_failure 字段当初(#118354)就是为了消灭"永远绿色的任务"才加的,这条路径绕过了它。
纽约时间 10 月 29 日凌晨第三次复发:两条定时任务先后阵亡,traceback 一路指向同一个 UPDATE、同一个异常。
报告者特意留了一句边界声明——runpy 警告出现在 traceback 之前,但这份证据不能确立它就是原因;除"接管处的 SQLite 锁"之外不断言任何根因。此前另两位用户都注意到,用户看到的报错第一行永远是那条无害的 RuntimeWarning,真正的锁异常埋在 stderr 深处;还有人证实失败 worker 的 .stderr 捕获文件根本没落盘,完整 traceback 只活在网关日志里。
一个 bug 的真实死因被一层噪音顶在前面挡了数周。
三个候选补丁加主分支基线,在 Windows 上同台
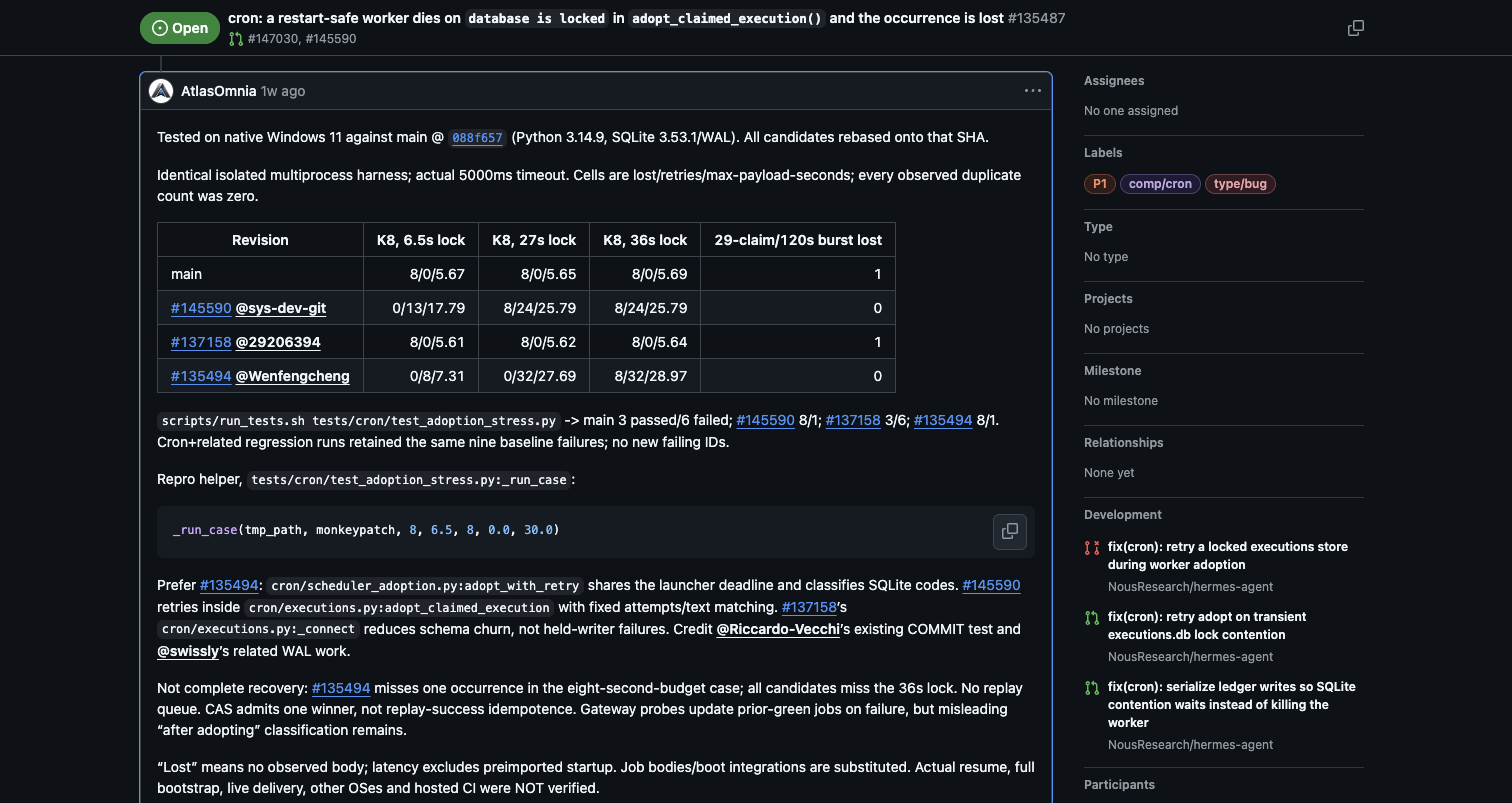
10 月底,社区把候选修复拉到同一把尺子下。Windows 原生环境上跑了四个候选的对照压测:主分支在 6.5 秒锁下丢 8 个任务,#145590 全部救回但耗到 17.8 秒,#137158 毫无帮助,#135494 零丢失且最快(7.3 秒)。测试基准同步跟上:主分支压力测试 3 过 6 挂,两个重试方案都是 8 过 1。
结论倾向 #135494:它把重试放在调度侧、与启动器共享同一个截止时间、按 SQLite 错误码分类;#145590 在账本函数内部重试、固定次数加文本匹配;#137158 减少的是 schema 开销,救不了持锁失败。
评论区里还躺着一份可直接应用的补丁(作者与提交 #145590 的不是同一人,思路同报告建议一):指数退避 0.05 秒到 1 秒,CAS 语义原样保留(rowcount==0 仍立即返回 None、绝不重试),无关异常仍第一次就抛出;补丁把网关的截止时刻盖进 worker 的任务载荷里传下去,worker 在网关停止等待之前自己收手,旧版网关的载荷没这个字段时退回宽限期减 2 秒确认预留。有意思的是这位账号开不了 PR(CreatePullRequest 被拒),只好把分支和补丁贴在评论里,请维护者以 Co-authored-by 名义收下。更早那位 macOS 报告者也遇到同样的门。
同一条对比评论写明剩余缺口:#135494 在 8 秒预算场景漏掉一次;面对 36 秒长锁四个方案全军覆没;没有重放队列;CAS 保证一个赢家,不保证重放幂等。即便最好的补丁合入,超过宽限期的 I/O 停顿依然会丢任务,只是概率变小。真正兜底要靠重放队列或对账机制,那是另一个设计决策。
截至 2026 年 11 月 6 日,issue 挂着 P1 标签(官方定义:主要功能损坏、无 workaround)仍然开着,无人认领;四条相关修复 PR 全部停在 open 状态,没有一条合入主干。
为什么这类故障专门杀 cron
把视角拉远一点。交互式会话里撞上锁超时,用户看到转圈多两秒,重试一下就是了;SQLite 自带的 busy handler 在这种场景基本够用。
cron 的不同在于三个结构性事实:worker 是被父进程 spawn 出来的一次性短命进程,从出生到"举手接活"之间只有几秒预算;它的每一次账本读写都各自开连接、各自付 WAL 重建和收尾 checkpoint 的成本;它失败了不会自己爬起来——父进程按协议等确认,等不到就判死,这一次触发永久消失。
短生命周期 × 高并发 fork × 每次写的连接开销,三个乘在一起,把"偶发磁盘停顿"放大成"每天少跑几次任务且看板全绿"。2026-11-05 的生态日报把这条 issue 列为 P1 且"未见 fix PR"——严格说社区有四条 open PR,准确的说法是没有一条进入维护者合并轨道
锁竞争在这个代码库里不会只出现在一条 issue 上——同一个仓库的账本读写路径处处共用这 5 秒预算。
对一个把"7×24 无人值守"当卖点的智能体框架,状态账本的可靠性就是产品承诺本身。用户可以接受模型偶尔犯蠢,很难接受定时任务静默蒸发。
如果你也在用 SQLite 养一群短命 worker
这个案例能直接搬走的检查有五件事,不分项目:
第一,核对你的超时预算链。网关愿意等 30 秒、worker 5 秒就放弃,这种不对称通常是分层配置各写各的结果,不是设计。把所有"等待方超时 ≥ 行动方重试预算 + 确认预留"写成显式约束。
第二,区分"可重试错误"和"该终止错误"。按驱动错误码分类(SQLITE_BUSY/LOCKED 才重试),不要匹配报错文本——文本会变,码不会。CAS 拒绝(rowcount==0)必须保持硬失败,否则会把并发正确性修没了。
第三,盯住 fsync 而不是只盯 CPU。主贴的全部真相浓缩成一句话:1.7 秒的磁盘停顿就能杀掉 5 秒预算的写入。云盘、快照、备份窗口、内存回收,都是账本写入的隐形对手。给关键写入路径记延迟直方图,别只记成败。
第四,审计你的失败通知链路。这个 bug 之所以难缠,一半原因是失败信号沿途失真:stderr 不落盘、用户看到顶部的无害警告、事件台账有的开行有的不开、jobs.json 干脆显示绿色。每一条观测通路都要问一遍"最坏情况下它显示什么"。凡是"执行行已终态但任务卡未更新"这类分叉路径,都值得像 aadityasood 建议的那样,在 worker 死亡路径上把 last_failure/failure_streak 一并盖章。
第五,如果你的部署规模不小,用 started_at IS NULL 这类不变量定期对账账本表,别信面板。单次事故里 44 条异常记录对应 24 个不同任务——逐个告警会被淹没,集合对账一眼见底。
至于这四个补丁最终谁进主干、什么时候进,是维护者的节奏。对使用者,眼下唯一稳的做法还是那位 Linux 用户的反面教材:本地补丁扛得住一时,扛不住一次自动更新。要么盯紧上游把修复带上,要么在升级脚本里加一步"autostash 残留检查"——至少别让修复在你不知情的时候悄悄消失。
一条锁超时的 issue,照出的是整个 agent 基础设施层的地基问题:进程可以重启,任务可以补跑,唯独"看起来一切正常"这五个字,是最贵的故障形态。
参考来源
- NousResearch/hermes-agent issue #135487 原始页面(含全部 11 条评论与实验数据,采集快照 2026-11-06):https://github.com/NousResearch/hermes-agent/issues/135487
- Big Model Radar《Hermes Agent 项目动态日报》2026-11-05(本机采集的 digest 文件,用于稳定性清单交叉比对)