ARTICLE / ai
插件拷贝卡死网关:单线程服务的同步IO病
2026 年 10 月 11 日,一位 Windows 用户让网关抓取一个亚马逊商品页。请求发出后,网关日志停在了 14:50:24,下一次事件循环延迟报告出现在 14:54:56:271656.7 毫秒——主线程被独占了四分半钟。期间 Discord 连接断开重连,超时回调一个都没执行,直到事件循环恢复后才补跑。进程没有崩溃,没有重启,日志里没有任何报错。
这是 OpenClaw 仓库(openclaw/openclaw)的 issue #166641 里记录的一次真实卡死。同类问题在 #160959 里被标为 P0、影响级别 crash-loop,两个 issue 至今都是 open 状态。把它们放在一起看,能看到一类单线程服务的经典病灶:不是慢,是主线程被一串同步文件操作独占——期间服务"活着",但什么都答不上来。
卡死的形态:接受连接,不回答内容
很多监控只判断"进程在不在",这类故障恰恰绕过了它。两次事件里,网关的 TCP 层照常接受连接,但对 /healthz 健康检查、WebSocket RPC、消息通道轮询一概不响应——#160959 的报告者记录到,一次启动后 /healthz 超时持续到第 7 分钟才恢复,而日志里的端口监听提示早在第 2 分 20 秒就打出来了。
也就是说:端口通了 ≠ 服务能用。你的健康检查如果在超时后才收到响应,或客户端表现为"连上了但请求全部超时",这台服务的进程还活着,但它的主线程正在别处忙。这种状态下重启进程是有效的(清掉了卡住的操作),但会把病根一起盖住。
病根:一条同步的插件捕获链
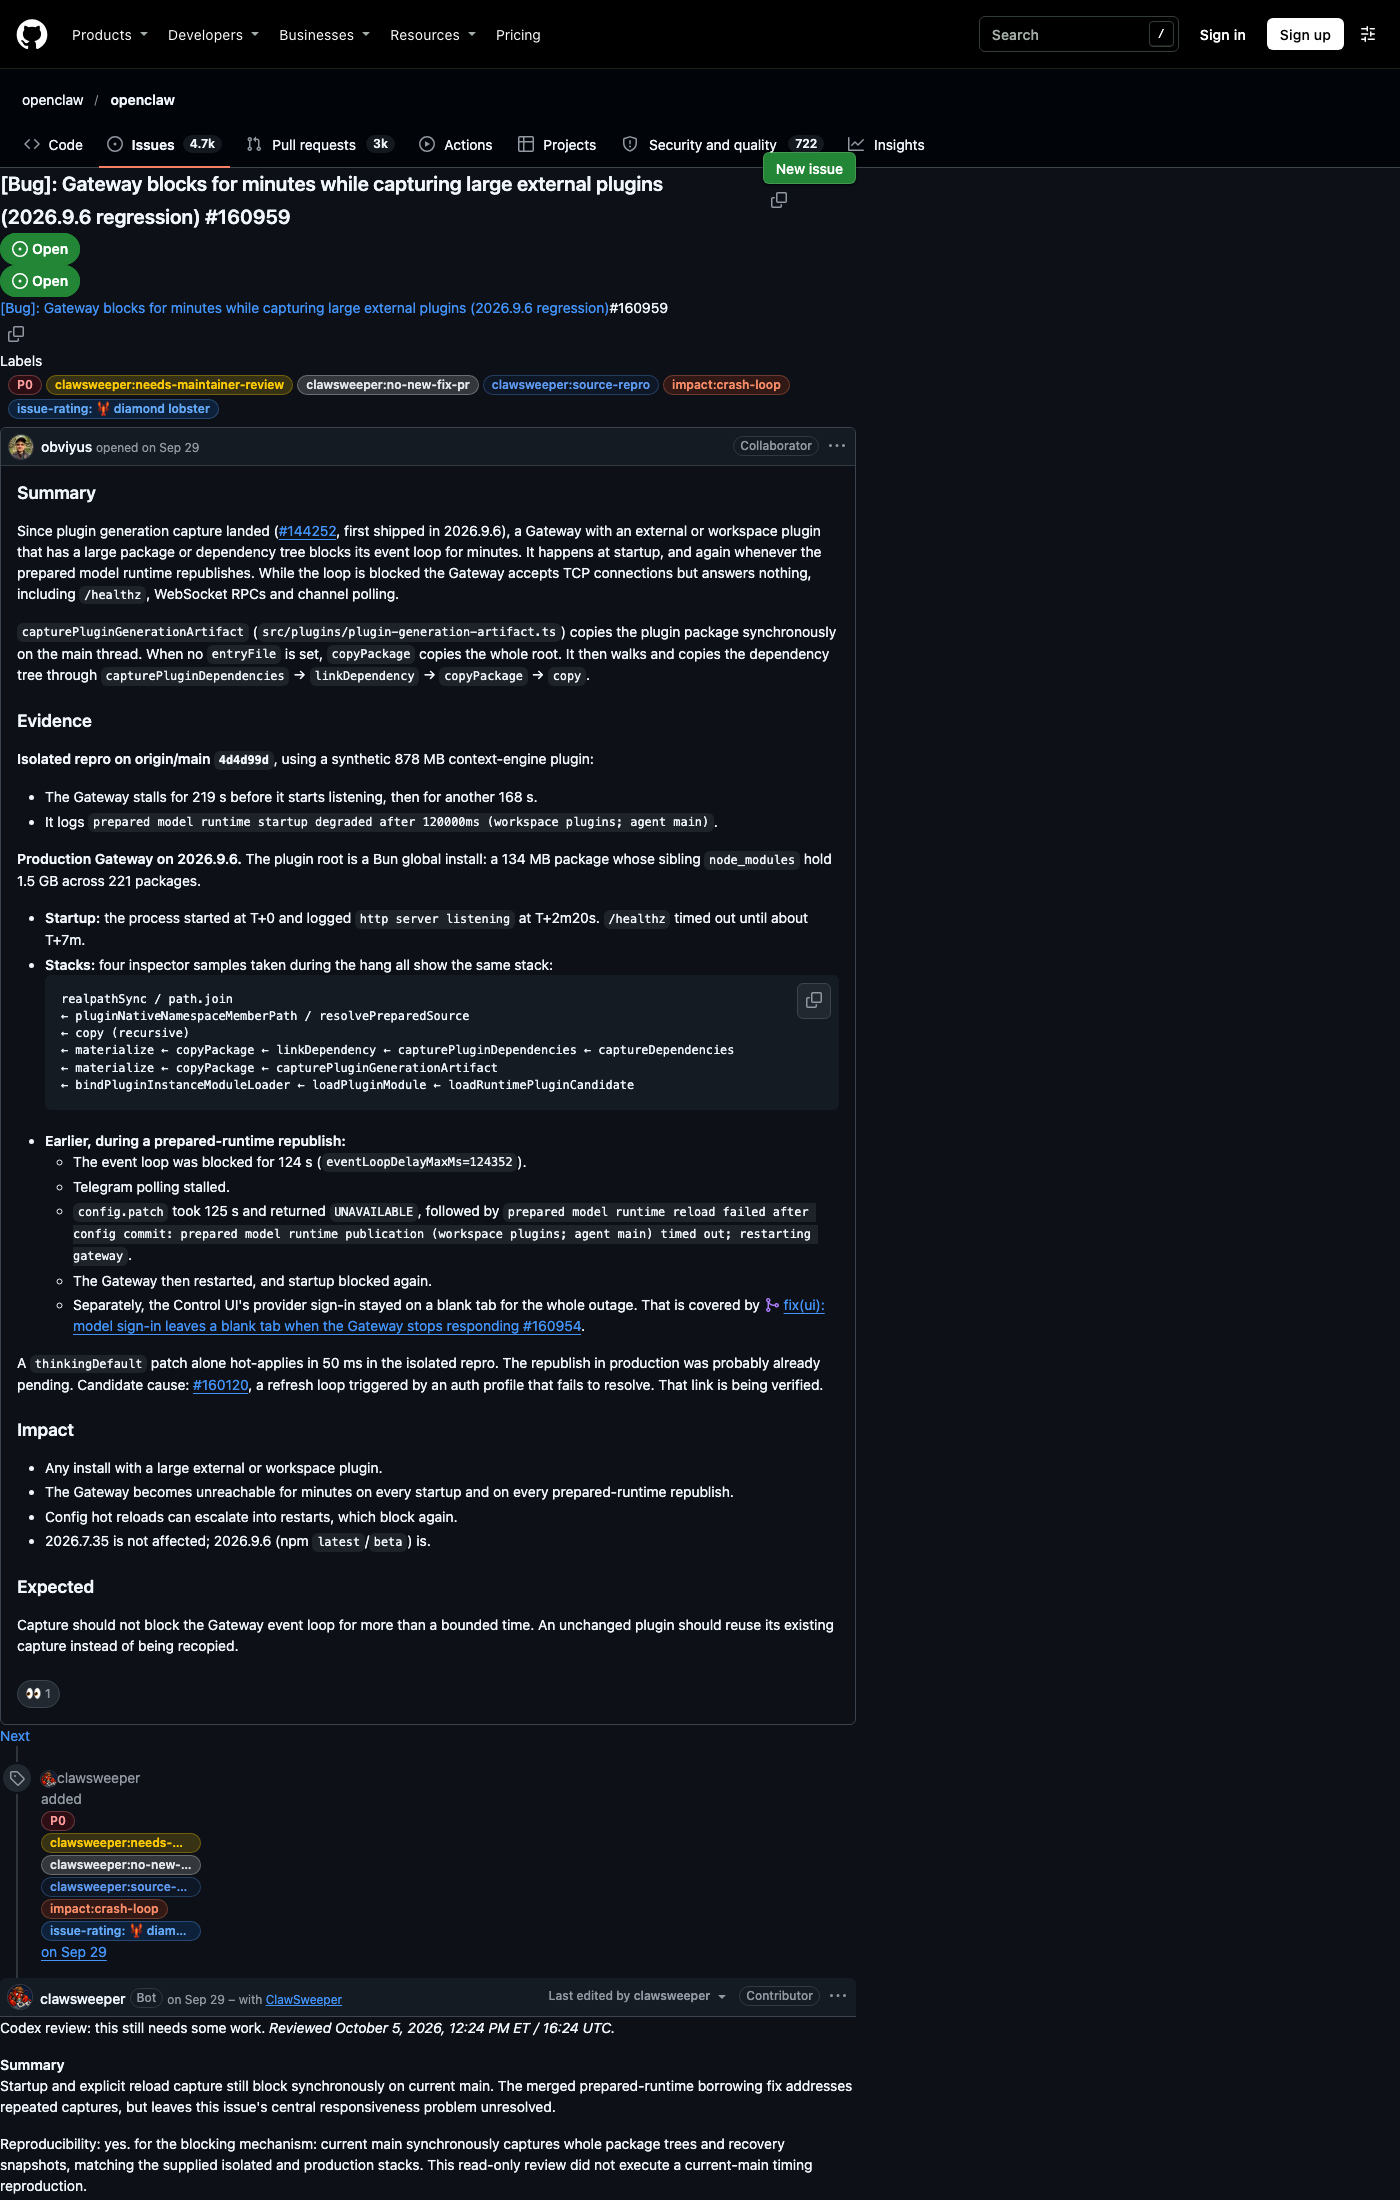
来源:github.com/openclaw/openclaw issue #160959 页面截图,2026-11-07 采集。P0、crash-loop 标签与作者复现数据见正文。
两个 issue 追到的是同一段代码路径。V8 CPU profile 把 12 秒的停顿几乎全部归因到一条调用链上:web_fetch 工具在找不到已配置的抓取提供方时,会走一条"冷回退发现"路径——进入通用插件加载器 loadRuntimePluginCandidate,最终调到 capturePluginGenerationArtifact。
这个捕获函数做的事,是对插件包做一次完整的同步文件系统物化:stat/lstat 元数据扫描、realpath 解析、目录枚举、哈希、逐文件拷贝。
#160959 把递归路径描述得更直接:当插件没有设置入口文件时,copyPackage 会拷贝整个包根目录,然后沿着依赖树递归——capturePluginDependencies → linkDependency → copyPackage → copy,一层层走下去。这一切都发生在网关的主线程上。
规模决定后果。#160959 报告者的生产网关上,插件根目录是一个 134 MB 的包,旁边的 node_modules 里还有 221 个包、共 1.5 GB。#160959 的报告者在隔离环境里做过对照:用一个 878 MB 的合成插件,网关启动前先停了 219 秒,随后又停 168 秒;而一个只改配置值的小补丁,热应用只花 50 毫秒。
#166641 的一次事件里,profile 记录到的"无辜者"更能说明问题:那次冷回退捕获了 6114 个文件、约 74 MB——其中 6088 个文件来自 Discord 插件,占掉几乎全部字节。Discord 根本不提供网页抓取功能,它只是被"发现路径"顺手拉进来拷了一遍。抓取提供方最终也没找到,页面内容照旧拿不到——这 12 秒的全部开销,花在确认"没有人能干这活"的路上。
报告者怎么排除其他嫌疑
这两个 issue 的质量之所以被仓库的评级机器人标为最高档(“diamond lobster”),是因为报告者没有停在"网关卡了"的现象上,而是把常见嫌疑逐一排掉了。
#166641 附了完整的排除清单:没有 SQLite 锁等待、没有数据库写超时、没有明显的 GC 停顿(整个事件里 GC 只占 0.13 秒)、没有容器内存压力或 OOM、没有 CPU 限流、宿主机调度也不拥挤。/proc 按 60 次采样,主线程 57 次处于可运行状态,只有 3 次短暂落在磁盘等待——说明这不是磁盘慢,而是主线程在逐文件地做系统调用。
还有一个干净的对照实验:同一台网关预热之后,直接抓取一个正常网页,1.7 秒完成,无任何停顿;再抓一个没有可读文本的页面触发同样的回退路径,1.6 秒完成,同样无停顿、无新的捕获动作。对照说明停顿只发生在"冷"状态下——第一次进入发现路径、捕获树还不存在的时候。
这套排除法值得每个遇到"服务间歇性无响应"的人抄一遍:先看事件循环延迟指标和 CPU profile 的调用栈,把锁、GC、内存、限流这些常见嫌疑定量排除,再谈别的。
修了一半,剩下的还在卡
这个问题不是没人修。#166641 关联的复审记录里写明,一次修复(commit f8f80ea)已经合并:它让解析器复用"精确代次"的插件注册表和完整的请求级清单,避免重复物理拷贝。
但 10 月 11 日那位 Windows 用户在本地把这次修复回移过去之后,同一个 web_fetch 请求再次把网关卡住了——这次是 245 秒。停顿期间的 CPU profile 里,758 个采样点无一例外全部落在同一条链上,其中 689 个落在带守卫的逐文件拷贝函数里。
复审意见点出了为什么补丁盖不全:插件清单"缺席"在这套设计里被刻意当成"非权威"状态——如果配置文件里没有任何清单声明某个能力,系统不会断定"没有",而是保留运行时发现未声明提供方的可能。于是冷回退路径保留了下来,而它调用的加载器是同步的。
要修干净,需要区分"清单确认过是空的"和"清单还没确认":前者可以直接返回空结果,后者才需要发现。这正是复审建议的方向——复用生命周期持有的完整清单,包括空结果,同时让必要的冷发现不阻塞事件循环。截至 11 月初的复审,这条路径在主干上仍然存在。
#160959 的处境更靠后:它被标为 P0,挂着"没有新修复 PR"的标签,等维护者复审。报告者在其中推测可能存在一个由认证档案解析失败触发的刷新循环(关联 #160120),这一条尚属推测,没有定论。
还有第三个触发点:11 月 5 日的一次 135 秒停顿,9 个采样点全部终止在同一个栈里——起点是子代理生命周期的收尾钩子,它调用插件注册表加载时没有传入可复用的注册表。也就是说,不只是 web_fetch,凡是走到"冷加载 + 同步捕获"组合的路径都能触发。在这类问题上,修一个入口不等于修完。
能带走的三条判断
第一,监控单线程服务,盯事件循环延迟,而不是进程存活。eventLoopDelay 这类指标在两次事件里都如实报出了 124 秒、245 秒、271 秒的独占——进程级别的存活检查全程是绿的。
第二,大文件树拷贝、依赖遍历、逐文件哈希这类活,不该出现在事件循环线程上。它们不产生 CPU 高负载(复现里 CPU 只用到约半个核),但每一个文件操作都是一次同步等待,串起来就是分钟级独占。“CPU 不忙但服务不响应"正是这类病灶的指纹。
第三,“修了但还会复现"的 bug,多半是修复只覆盖了一个入口。一条同步调用链有多个触发点(启动、配置重发布、工具冷回退、子代理收尾),只堵住其中一个,剩下的入口会在意想不到的时刻把同一段代码再跑一遍。
这两个 issue 目前都还开着,修复讨论仍在进行。对正在跑类似网关的人,当下能做的最实际的事:确认插件目录里有没有大体积依赖树,有条件的话让冷加载路径避开主线程的社区补丁思路(跳过无范围的完整加载)值得一读——但要记得,那是在修改过的环境里验证的,不是官方修复。
参考来源
- openclaw/openclaw issue #160959《Gateway blocks for minutes while capturing large external plugins (2026.9.6 regression)》(github.com,2026-09-29 创建,采集于 2026-11-07)
- openclaw/openclaw issue #166641《web_fetch cold fallback discovery synchronously captures unrelated plugins on Gateway main thread, causing liveness stalls》(github.com,2026-10-07 创建,含 ClawSweeper 2026-11-01 复审与后续复现记录,采集于 2026-11-07)