ARTICLE / ai
子代理报成功却没做完的另一种坑:Qwen Code 子代理开局 105k 上下文去向不明
一位 Qwen Code 桌面版用户在 2026 年 10 月 26 日提交了 issue #15660:
父会话只用了 42k 上下文,其中约 21k 来自启动加载(skills、AGENT.md、memory 等),发给子代理的提示词只有 1k——但推理引擎报告子代理会话开局就是 105k 的 prompt。
此后每启动一个子代理,开局上下文还会再涨 1k 到 3k。
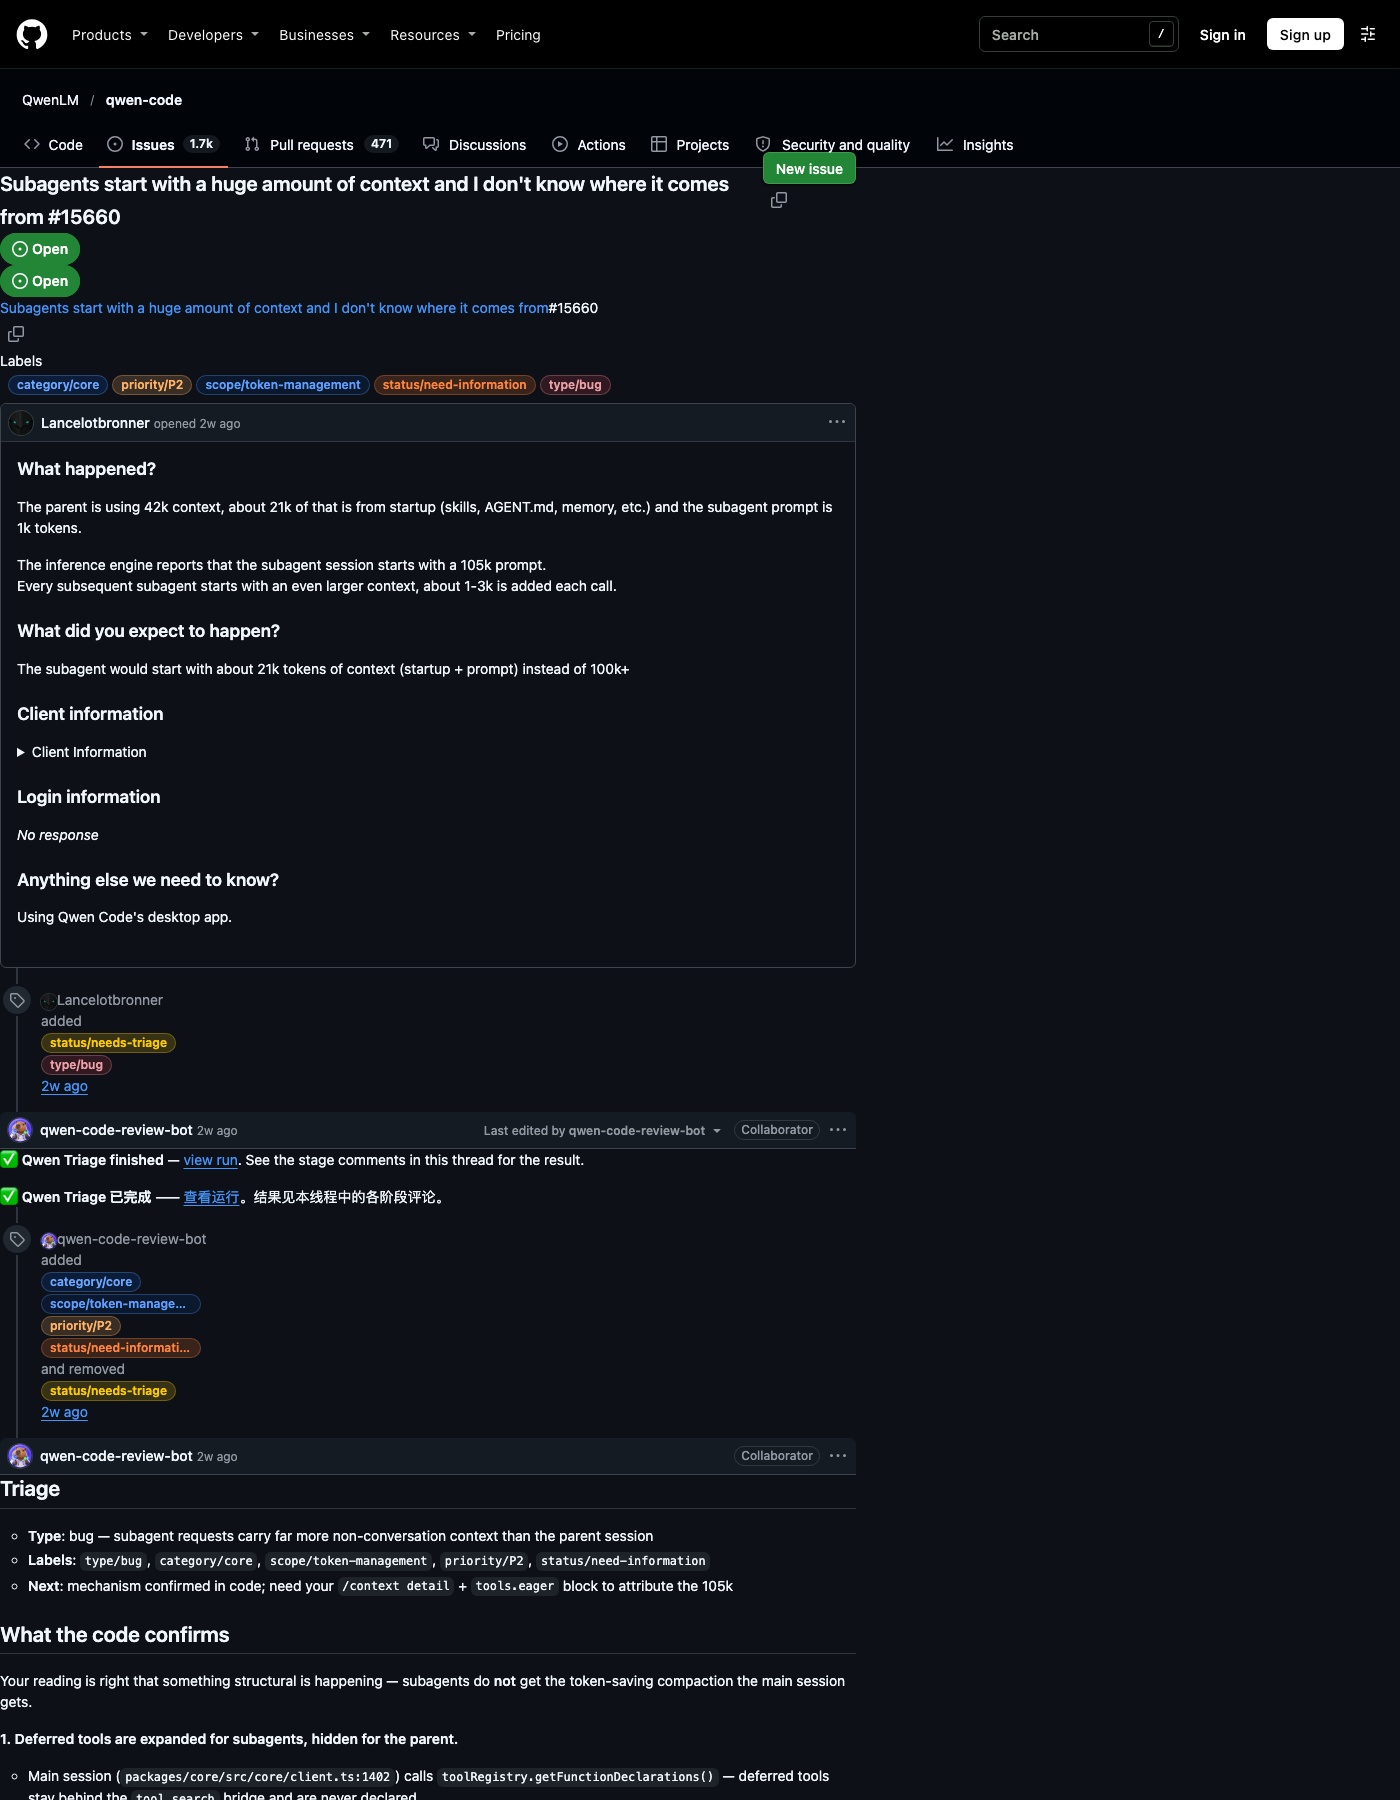 来源:GitHub QwenLM/qwen-code issue #15660 页面,github.com,截取日期 2026-11-12
报告者给出的数字链
这个报告的可贵之处在于它不是"感觉变慢了",而是一组可以直接对账的数字。父会话 42k,其中启动部分约 21k;子代理任务提示词 1k;按常理,子代理的开局应该在 21k 加 1k 附近,也就是两万多 token。实际观测是 105k,中间有约 80k 的差值没有任何来源说明。
报告者还观测到递增现象:每追加一次子代理调用,下一次子代理的开局上下文增加 1k 到 3k。这暗示有什么东西在父子之间反复搬运并且不断累积——可能是父会话的历史被整段注入子代理,也可能是会话状态没有正确隔离。
从 issue 的元数据看,报告者使用的是 Qwen Code v0.26.1 桌面版,运行在 macOS arm64 平台,模型走本地 openai 兼容端点。
项目维护方的 triage 机器人给这条 issue 打上了 category/core、scope/token-management 和 priority/P2 标签,状态为 need-information——也就是说官方承认它属于核心的 token 管理问题,但还在等补充信息,尚未给出根因解释或修复。
为什么这类问题值得普通使用者也关心
对用托管 API 的用户,token 直接是钱。子代理本来是把大任务拆小、让每个子任务在干净上下文里跑的手段;如果每个子代理都背着 105k 的隐形成本启动,拆分任务不但省不了钱,反而比不拆更贵。以报告中"每次再多 1k-3k"的膨胀速度,一个循环调用十几次子代理的工作流,浪费会持续累加。
对用本地模型的用户,影响换了一种形式:上下文窗口是固定资源,105k 的无谓占用会直接压缩模型可用的有效记忆,长任务后半程质量下降、被迫更早触发压缩,都是连带后果。
使用者现在能做的自查
在官方修复之前,有两条务实的自查路径。第一,如果你的推理后端能报告每次请求的 prompt token 数,对比父会话上下文与子代理首请求的数字,差值异常大就说明你也踩中了这个问题。
第二,控制子代理的调用频次和循环深度,报告中"每次膨胀 1k-3k"意味着调用次数越多浪费越大,把"让子代理顺手做一件小事"改成批量处理,能实打实降低损耗。
另外注意这条 issue 处于 need-information 状态,官方明确在等更多信息。踩中同样问题的用户在 issue 里补充自己的 /about 输出和观测数字,是推动修复最快的方式。
本文的资料依据与局限
本文全部数字来自 issue #15660 报告者的单方陈述及其客户端信息,issue 状态为 open 且未获维护者复现确认,80k 差值的成因(父历史注入还是状态泄漏)是依据现象的推测,不是官方结论。膨胀是否在 v0.26.1 之后的版本中仍存在,需以官方后续回复为准。
参考来源
- QwenLM/qwen-code issue #15660《Subagents start with a huge amount of context and I don’t know where it comes from》(采集日期 2026-11-12)