ARTICLE / ai
子代理报成功却没做完:Gemini CLI 的假成功与无限挂起
子代理报成功却没做完:Gemini CLI 的两个可靠性坑和一个超时开关
2026 年 3 月 9 日,一个用户在 google-gemini/gemini-cli 仓库提交 issue #22323,让 Gemini CLI 分析两个本地仓库的架构。主代理正常调起了 codebase_investigator 子代理,传入了一个具体的调查目标。
先说清性质:这是软件可靠性缺陷,不是入侵,没有攻击者参与也没有数据被窃取。同一个仓库里还有另一类形态——子代理调用根本不返回。这两类失效都会让你的自动化链跑偏,本文的重点就是怎么区分它们。
返回结果是这样的:工具调用状态 success,终止原因 GOAL。
同一次返回里嵌着另一段话——调查因为系统强制终止(超出最大轮数)被打断,RelevantLocations 是空的,压根没做任何分析。用户翻出的会话日志逐行印证了这种自相矛盾。
一个 status 字段,两套事实
用户贴出的日志片段很关键。session 文件里第 50 行是工具名 codebase_investigator,第 53 行是目标描述,第 61 行同时写着 Termination Reason: GOAL 和"调查因超出最大轮数被系统强制终止",同一行的 RelevantLocations 是空数组。第 66 行是 "status": "success"。第 79 行是主代理自己的判断:子代理因轮数上限没能完成分析。
也就是说,一次调用在结构化元数据层面报成功,在内容层面报失败。
报告者把问题定义为"终止元数据内部不一致":父工具调用被呈现为 status: "success" 加 Termination Reason: "GOAL",但内嵌负载描述的是一次因上限而提前终止的、零发现的任务。
这件事对写自动化的人意味着什么,比 bug 本身更值得说:如果 Agent 把它自己的工具返回直接当成事实往下走,这类不一致会一路传下去。一个"成功但没做事"的子代理结果,如果被自动化链路直接采信,空结果会继续往下传,直到某个环节才发现问题。
另一个坑:不是失败,是永远不回来
issue #21409 描述的是完全相反的失败模式。报告者说,只要 gemini-cli 把任务转交给 generalist agent,就会永久挂起。简单到"创建一个文件夹"这种操作也会卡住,他最长等过一小时。
他试出的绕法是:明确指示模型不要转交给子代理,任务立刻就做完了。他也试过加 --debug,拿不到更多根因信息。
这个 issue 的标签是 priority/p1、area/agent,报告环境是 CLI 0.32.1、Linux、无沙箱、模型 Auto (Gemini 3)。评论区里有其他用户说自己也遇到,“已经挂了 16 小时”。
两个 issue 摆在一起看,暴露的是同一层信任缺口的两种形态:一端谎报成功,另一端沉默不归。报告者给出的应对是绕开——让模型不要转交子代理。评论区另一位用户则报告说,在 0.34.0-nightly.20260304.28af4e127 这个夜间版本上问题消失,可以自行从源码构建;这是一个用户的观察,不等于官方确认。
社区在推的补丁方向:给工具调用加超时
对挂起这一类问题,仓库里有一条正在推进的 PR #30212,标题是"新增可配置的单次工具调用超时(tools.callTimeout)"。它给出的配置形如 { "tools": { "callTimeout": 5 } },单位是秒,默认值 0 表示不启用。
超时触发后,工具的 AbortSignal 会被触发,这次调用以一个可恢复的 TOOL_CALL_TIMEOUT 错误结束——PR 的描述强调这个错误是"可恢复"的,目的是让模型换个策略,而不是把整个会话拖死。
PR 里还记录了一处工程细节:实现刻意没有使用 AbortSignal.any,因为那需要 Node 20.3 以上,而项目的 engines 字段允许 20.0。这条信息看起来琐碎,但它解释了为什么补丁不是一行代码。
评论区的实测记录给了一个具体读数:PR 作者在 macOS、Node 22 上用真实的 ShellTool 跑 sleep 37,走 ToolExecutor 并设 2 秒上限,调用在大约 2.1 秒处返回 TOOL_CALL_TIMEOUT,随后用 pgrep 确认那个本该被终止的进程已经不在了。也就是说,超时机制除了返回失败信号,在这次测试里还清理了被中止的子进程——挂死的工具调用留在后台继续跑,会让排查变得更难。
PR 描述里提到的关联问题是 #3375,PR 作者说自己在这个 PR 里回应了 #3375 的评审意见。#3375 讨论的是单次工具调用缺超时控制,而 #21409 是转交子代理后不返回——加上 PR 明确豁免子代理调用,这个开关并不直接覆盖 #21409 的形态。
一个必须注意的例外
PR 里明确写了子代理调用是豁免的。原文的理由是:子代理有自己的时间预算,硬杀掉它(比如 60 秒)会把子代理已经完成的工作全部丢掉。
豁免的是"调用子代理"这一步本身,子代理内部发起的工具调用仍然走 ToolExecutor,也各自受这个超时约束。
这个例外直接决定了上面的超时开关对本文讨论的两个 issue 能覆盖多少:#21409 那种"转交给 generalist agent 之后无限挂起"的形态,挂起的是子代理调用本身,超时开关按设计不会去打断它。这个开关解决的是"工具调用挂死",不是"子代理挂死"。
现在能做什么
如果你正在用 Gemini CLI 的子代理功能,有三条可以立刻落地的判断。
第一,别把 status: "success" 当作子代理确实完成了分析的证据。要看的是内容层:目标是否被识别、相关位置是否为空、结论里有没有具体的文件路径或代码位置。零发现配一个成功状态,是 #22323 的特征形态。
第二,检查点只对已经返回的任务有用。任务返回了,你可以核对它的内容;任务不返回,人工检查点也无从下手。这种情况下,#21409 报告者验证过的处置是不让模型转交子代理;评论区另一位用户给出的线索是换到某个夜间构建。如果某类任务你必须用子代理,那就把"这次子代理到底做没做事"变成显式的检查项,而不是相信元数据。
第三,关注 #30212 之后合入的工具调用超时能力。它能把挂死的工具调用转成明确的失败信号而不是无限等待,但按上面的例外,它不覆盖子代理调用本身的挂起。
#22323 和 #21409 里的现象都是报告者在各自环境上的观察,复现条件各不相同——一个是 2026 年 3 月的会话日志,一个是 0.32.1 的 Linux 交互环境。#30212 是仍在推进中的 PR,尚未在发行版里落地。这两类失效不是同一回事:一个是元数据与内容不一致,另一个是根本不返回。它们只共享一个检查动作——不能凭状态字段确认子代理真的做完了事。
对工具调用挂死这一类,目前还没有兜底手段——#30212 仍是 open 的 PR。
参考来源
- google-gemini/gemini-cli issue #22323:Subagent 达到 MAX_TURNS 后误报 GOAL success,采集日期 2026-11-11
- google-gemini/gemini-cli issue #21409:Generalist agent hangs,采集日期 2026-11-11
- google-gemini/gemini-cli PR #30212:feat(core): add configurable per-tool-call timeout (tools.callTimeout),采集日期 2026-11-11
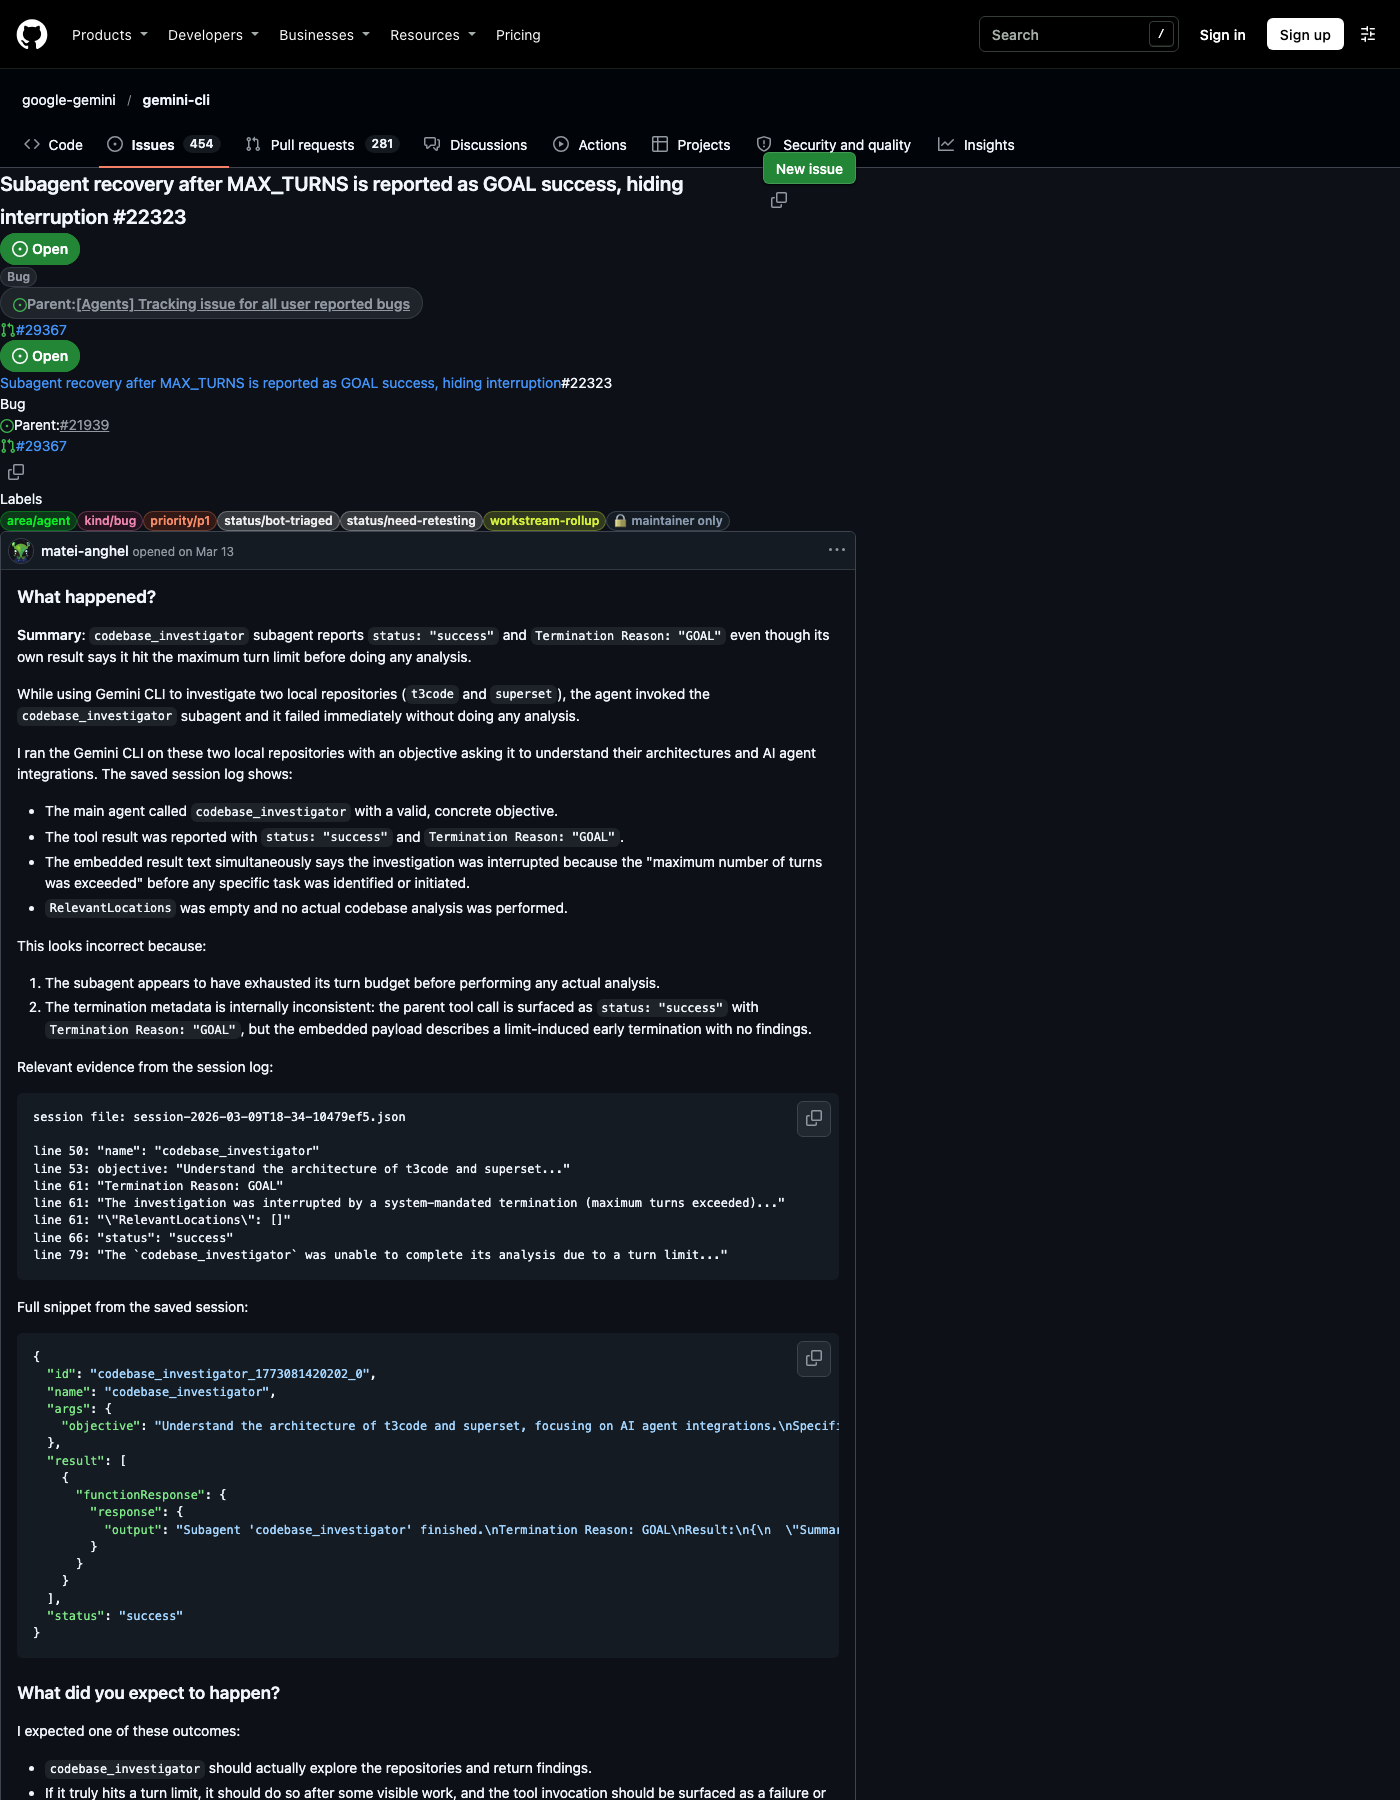
图:github.com/google-gemini/gemini-cli issue #22323 页面,截取日期 2026-11-11。