ARTICLE / ai
自托管网关的三种假死:服务没崩,机器人却不说话了
把 Claude Code、Codex 这类编码 CLI 换成自托管的 Agent 网关之后,运维里最耗时间的往往不是"服务挂了"——那种情况看门狗一眼就能看出来。真正难缠的是三种状态:进程活着、日志还在写、但用户那边就是没响应。
11 月 9 日前后在 OpenClaw 仓库里还在更新的一批 issue,正好把这三类情况分得很清楚。它们分别对应启动阶段、休眠唤醒之后、升级过程本身,同一个表象(消息进来了没人回)在底层是完全不同的故障。
第一类:启动时事件循环被堵死,看门狗自己把它当成断线
OpenClaw issue #162211 描述的是一种很具体的自伤循环。Gateway 启动期间,有几个阶段会把事件循环占满 40 到 200 秒,CPU 占用接近一个核心的 100%,而队列里 active: 0 / waiting: 0 / queued: 0——没有任何任务在跑,纯粹是主线程被同步工作占住。
问题出在随后的连锁反应上。渠道健康监视器在这段时间里错过了自己的心跳,于是把通道状态判为 stopped 或 disconnected,触发 Gateway 重启;重启又回到同一条慢启动路径。
报告者贴出的日志显示三个账号在同一毫秒被判定重启。他给出的主机上每日重启计数是 2、7、18、148、161。最后一天 161 次里有 159 次是 reason: stopped——也就是监视器在自己刚重启完、通道还没回来的时候再次触发了重启。
更值得看的是它的算术。日志里 Gateway 自己打印了对 launchd 额度的预算:drain 5 秒、shutdown 15 秒、reserve 10 秒、exitMargin 5 秒,合计 35 秒;而 launchd 的 ExitTimeOut 只有 20 秒。预算超出额度,进程在退出时序里被 SIGKILL,KeepAlive 再把它拉起来,循环闭合。
报告里给出的一个可验证的缓解手段是把宿主的 ExitTimeOut 从 20 秒提到 60 秒,随后 8.5 小时内重启计数和稳定性事件都是 0。作者自己写明这是宿主侧的缓解,不是修复——底层的阻塞还在,而且账号没有办法关掉触发这个重启的机制。
更别扭的一点是那个"关不掉"。文档里写了按渠道和按账号关闭健康监视器的配置项,运行时代码也确实读同一个键,但插件自带的 JSON schema 没有声明这个属性,于是配置命令直接被 schema 拒绝:
同一问题在账号层级也一样,而 openclaw config set 没有跳过校验的开关。文档写了、代码读了、schema 不让填——这类"配置存在但配不进去"的缝隙,比功能缺失更难排查,因为它在文档层面看起来是可用的。
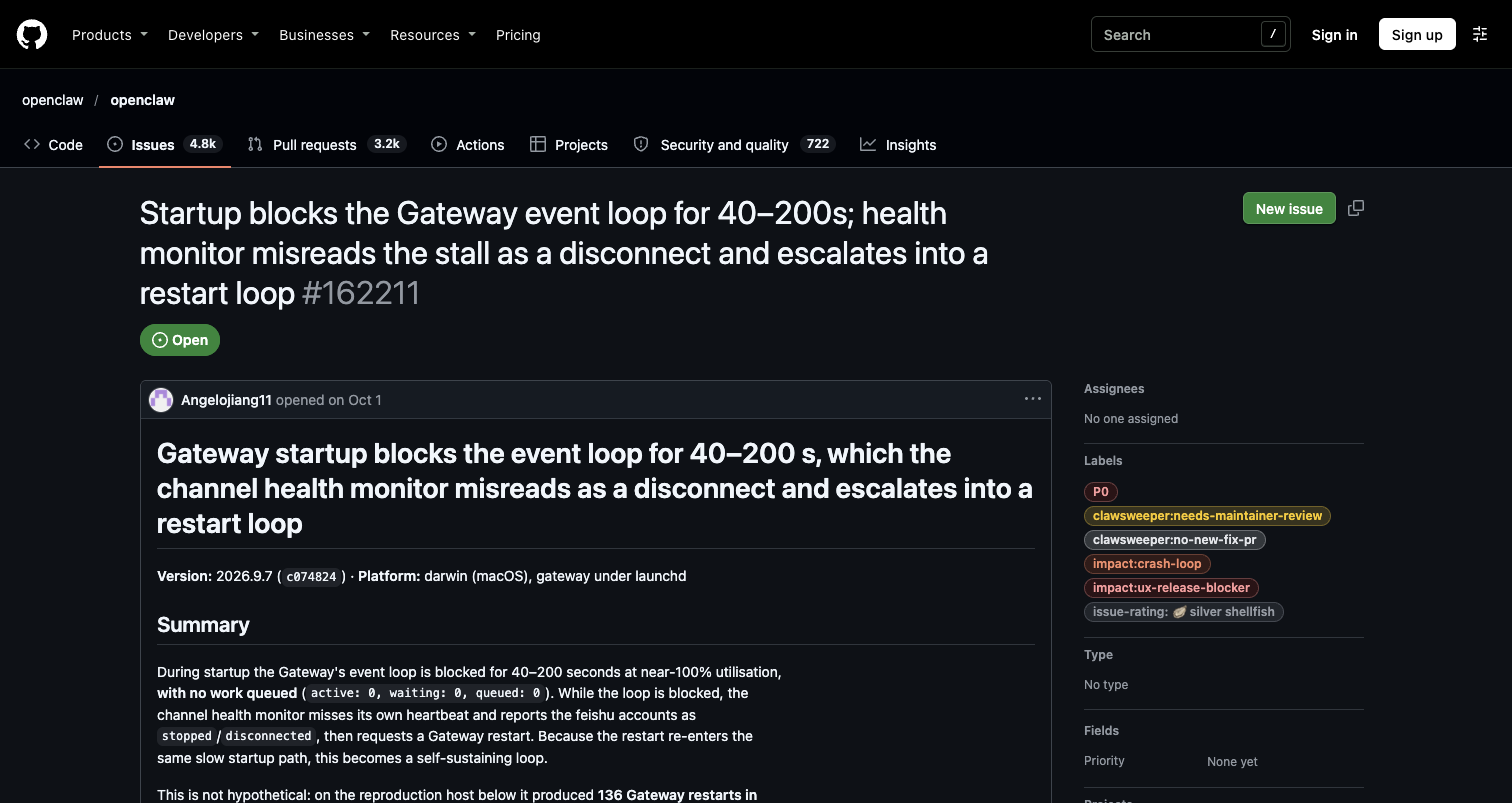
图:github/openclaw/openclaw issue #162211 页面,截取日期:2026-11-10。
第二类:主机休眠之后,某个 Agent 的运行时再也发布不出来
OpenClaw issue #158592 是另一种"看起来还活着"。主机在 09-25 约 21:20 休眠,22:19:58 唤醒时日志里是这么写的:
从这一刻起,那个 agent 的运行时 owner 一直没有重新发布成功。每一条进站消息都瞬间失败,错误是 prepared reply dispatch runtime owner was not published for main。报告者统计这个状态持续了 10 个多小时没有自愈,最后是重启 Gateway 才恢复。
中途也试过进程内重试:09-26 04:46:31 手动通过 session_status 工具触发一次,得到的还是同一个超时。08:24:48 走 RPC 再触发一次,同样的错误。等到 08:45 因为升级到 2026.9.6 重启了 Gateway,agent 立刻恢复健康,之后的派发错误是 0,之前失败的用户消息重发后也能正常处理。
有一个细节说明了问题的性质:同一时间窗口里,另外三个 agent 的运行时都刷新成功了,只有 main 失败。报告者给出的解释是超时之后 owner 停在了一个 needsRefresh 的状态,后续发布尝试即使在系统完全空闲时也会继续超时。
用户侧看到的症状非常容易误判:平台投递是成功的,Gateway 日志里也记录了收到了消息,机器人却一直不回应。这时候去查网络、查模型、查配额都是白查——故障在 Gateway 内部的运行时发布环节。
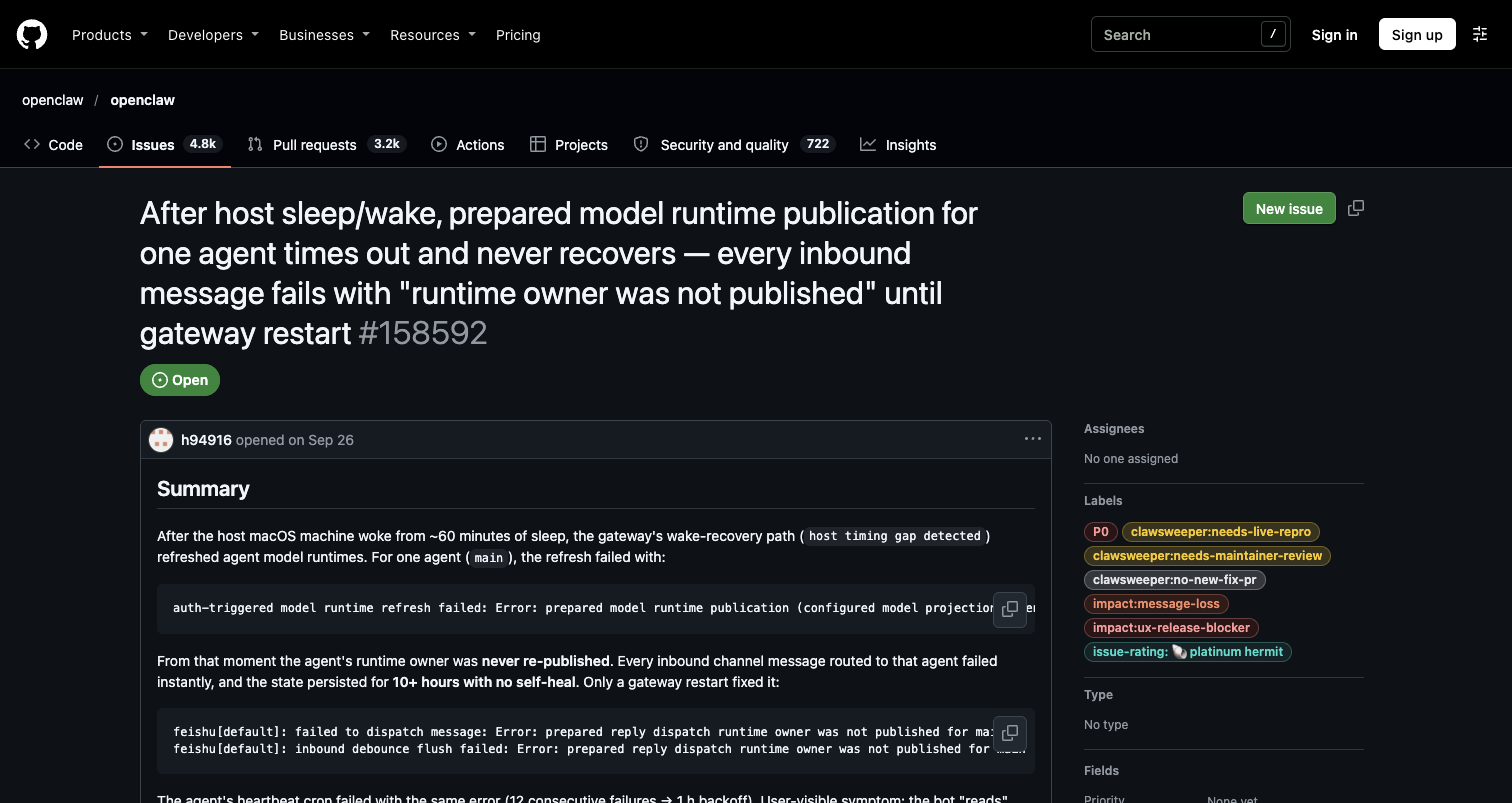
图:github/openclaw/openclaw issue #158592 页面,截取日期:2026-11-10。
第三类:升级本身把路堵死
OpenClaw issue #193962 讲的是一个更绕的情况:一个已经修好的 bug,恰恰在需要它的机器上修不了。
背景是 #187150 的超时问题由 #187197 修好,修复随 2026.11.5-beta.1 发布。问题在于,从 2026.10.10 升级到 2026.11.5-beta.1 的那条命令本身会失败,报错同样是 spawnSync node ETIMEDOUT,而且失败在 package-update 这一步。
原因在于探测代码来自哪里。package-update 这一步跑的是"保留的升级运行时"——一份已安装包的副本,也就是 2026.10.10 的旧代码,而不是候选新版本里的修复版本。所以新版本修好了备份探测,但升级路径用的还是旧代码去探测。报告者给的数据是:状态目录里约 16 万个文件,探测 worker 处理其中 3.26 万个要 10.3 秒,处理全部文件要 44 秒,而超时上限是 10 秒,一次跑完是跑不完的。
验证方式也很硬:报告者只改了已安装副本里的 dist/backup-sqlite-snapshot-*.mjs,把 probeSqliteDatabaseHeaders 换成 2026.11.5-beta.1 的分批版本,候选包和状态目录都没动,同一条升级命令就一路跑完了校验、激活、重启和验证。
issue 里给出的三个修法方向也值得记:升级前的备份用候选版本的备份代码跑;把 #187197 反向移植到 2026.10.x / 2026.11.x 稳定线,让中间版本自己能升级过去;以及探测超时时直接说超时并给出受支持的下一步,而不是丢一句"检查源文件是否可读"。
这类问题的共同点是:故障不发生在你正在用的功能上,而发生在"把你送到修好版本的那条路上"。所以它会一直存在,直到有人专门去修那条路。
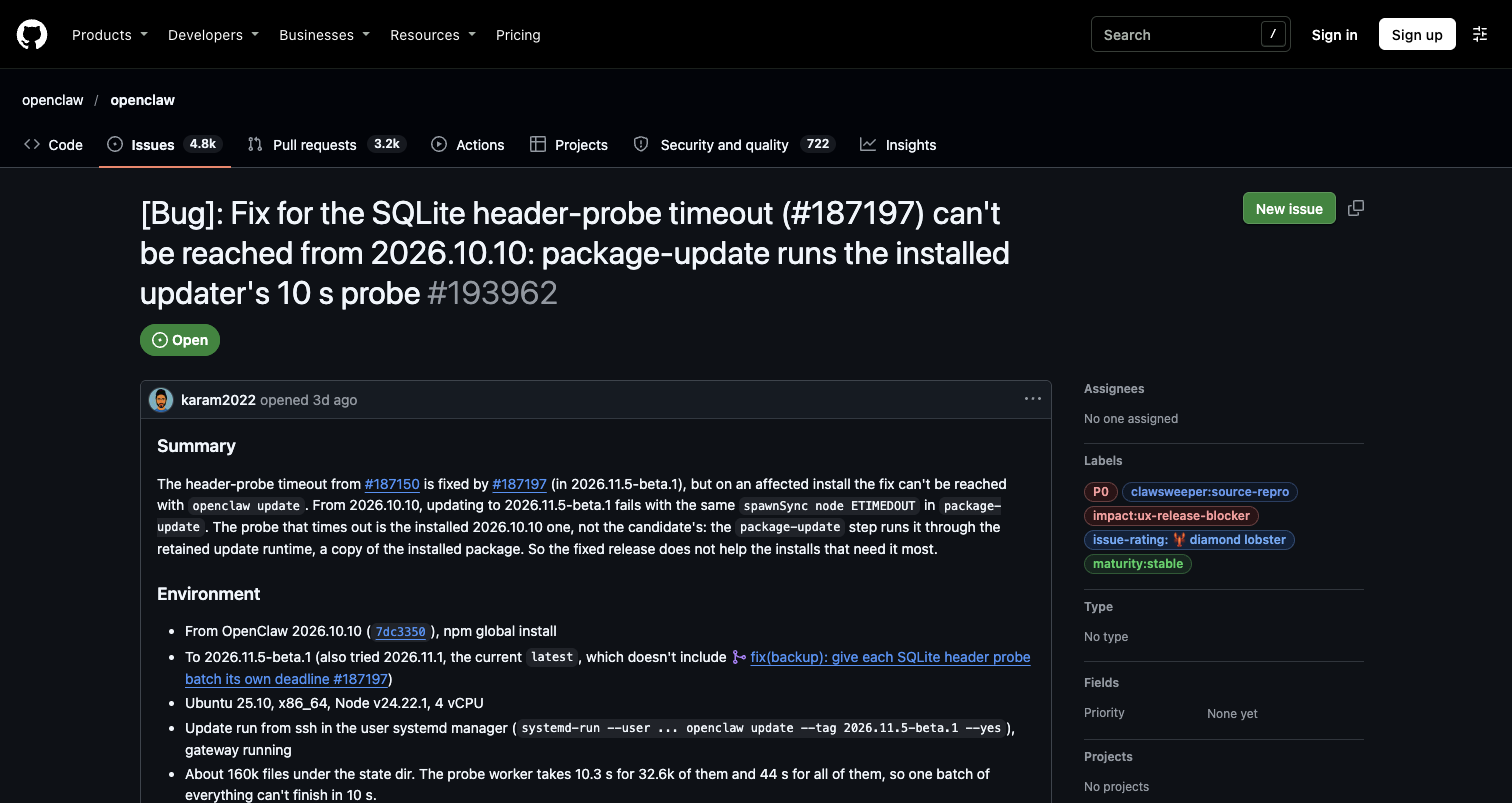
图:github/openclaw/openclaw issue #193962 页面,截取日期:2026-11-10。
顺带一个数据点:内存回归比想象中更难查
内存治理也是同一批 issue 里反复出现的方向。OpenClaw issue #181432 报告的是一次升级引入的基线内存回归:在 Linux ARM64 上从 2026.9.4 升到 2026.10.5,Gateway 启动即空闲时的 RSS 从大约 300 MB 涨到 1.89 GB,15 个 worker 线程各自占着一块堆。
接着 Telegram 消息进来就出现超过 1.5 秒的 SQLite 事务持有,最终报 idempotency key conflicts with the admitted message。回滚到 2026.9.4 后任务数从 77 降到 12,基线内存也回到正常水平。
而 issue #162211 里也有一份对比数据,说明同一个方向上的问题被修掉过一部分:prepared-model-catalog.worker.js 的堆占用在 2026.9.7 升级前是 1857–3129 MB,升级后降到 206–299 MB。Gateway 整体 RSS 也从 3.7–4.8 GB 的区间回落到 2.1–2.5 GB 区间,残留漂移约每小时 33 MB。
这两条放在一起看,说明内存类问题在自托管场景里是持续起伏的——修好了会掉下来,也会在某次升级后重新涨上去,而"当前版本稳不稳"这个判断只在特定版本上成立。
遇到"假死"时先分清是哪一类
这三类故障的表象几乎一样,处理方向完全不同。可以按这个顺序排查:
看进程与队列状态是否背离。日志里如果
active: 0 / waiting: 0 / queued: 0却 CPU 接近满载,那是启动或后台阶段的同步阻塞,不是任务积压。可以对着 issue #162211 提到的三个阶段查:sidecars.model-runtime、sidecars.control-ui-assets、plugins.runtime-post-bind。看重启计数和重启原因。
reason: stopped大量出现,说明是健康监视器在自己刚重启完又触发重启,而不是真的断了连接。这种情况下调整宿主的进程退出超时,是一个成本很低的验证手段。看是不是宿主休眠唤醒之后才出现。如果故障时间点紧跟一次唤醒事件,且只影响部分 agent,那么进程内重试没有意义——同类故障的记录显示,进程内重试和 RPC 重试都拿回同一个超时,最后靠重启恢复。
看是不是刚升级过。如果升级命令本身失败,或者升级后行为突变,优先怀疑升级路径本身,而不是新版本的功能。
需要说明的是,以上四步是排查顺序,不是通用结论。这些 issue 都是报告者单方提交的记录,维护者的复现结果和替代解释需要读完整的评论区才能确认——其中 #181432 被标记了 no-new-fix-pr 与 needs-maintainer-review,说明修复路径还在讨论中。
一句话留给运维
自托管 Agent 网关最容易被低估的故障,是那些进程活着、日志正常、但用户侧完全没响应的状态。它们大多不是网络、不是配额、也不是模型可用性问题,而是网关自身在启动、唤醒和升级三个时刻的状态管理出了偏差。遇到这类问题,先把故障归到"哪个阶段、哪个环节"上,再谈重试——因为这几类故障里,重试的收益通常远低于一次重启或一次针对性配置调整。
参考来源
- OpenClaw issue #162211 Startup blocks the Gateway event loop for 40–200s(2026-09-30 提交)https://github.com/openclaw/openclaw/issues/162211
- OpenClaw issue #158592 After host sleep/wake, prepared model runtime publication times out(2026-10-08 更新)https://github.com/openclaw/openclaw/issues/158592
- OpenClaw issue #193962 升级通道自锁,修复版本无法到达(2026-11-09 更新)https://github.com/openclaw/openclaw/issues/193962
- OpenClaw issue #181432 Excessive baseline RSS memory (~1.9 GB) and SQLite transaction timeouts(2026-10-23 提交,2026-11-08 更新)https://github.com/openclaw/openclaw/issues/181432