ARTICLE / ai
Agent Reach:给编码 Agent 补上够不着的互联网
Claude Code、Codex、Hermes Agent、OpenClaw 这类 CLI Agent 自带搜索和网页读取,但有一批平台它们基本够不着:要登录才能用的(小红书搜笔记、X 查账号动态、读职位详情),视频里的内容(B站和 YouTube 字幕、YouTube 视频和小宇宙播客的语音转文字),以及中文平台(B站、小红书、V2EX、雪球,通用搜索覆盖很差)。
Agent Reach 是一个开源 CLI,定位很明确:把这些平台背后的工具替你装好、测好,Agent 一条命令就能用。它的 README 里给的用法是三条命令:
第三条是它和普通"网页读取器"最大的区别:给一个链接,它自动判断该走哪个渠道,而不是让 Agent 自己猜。
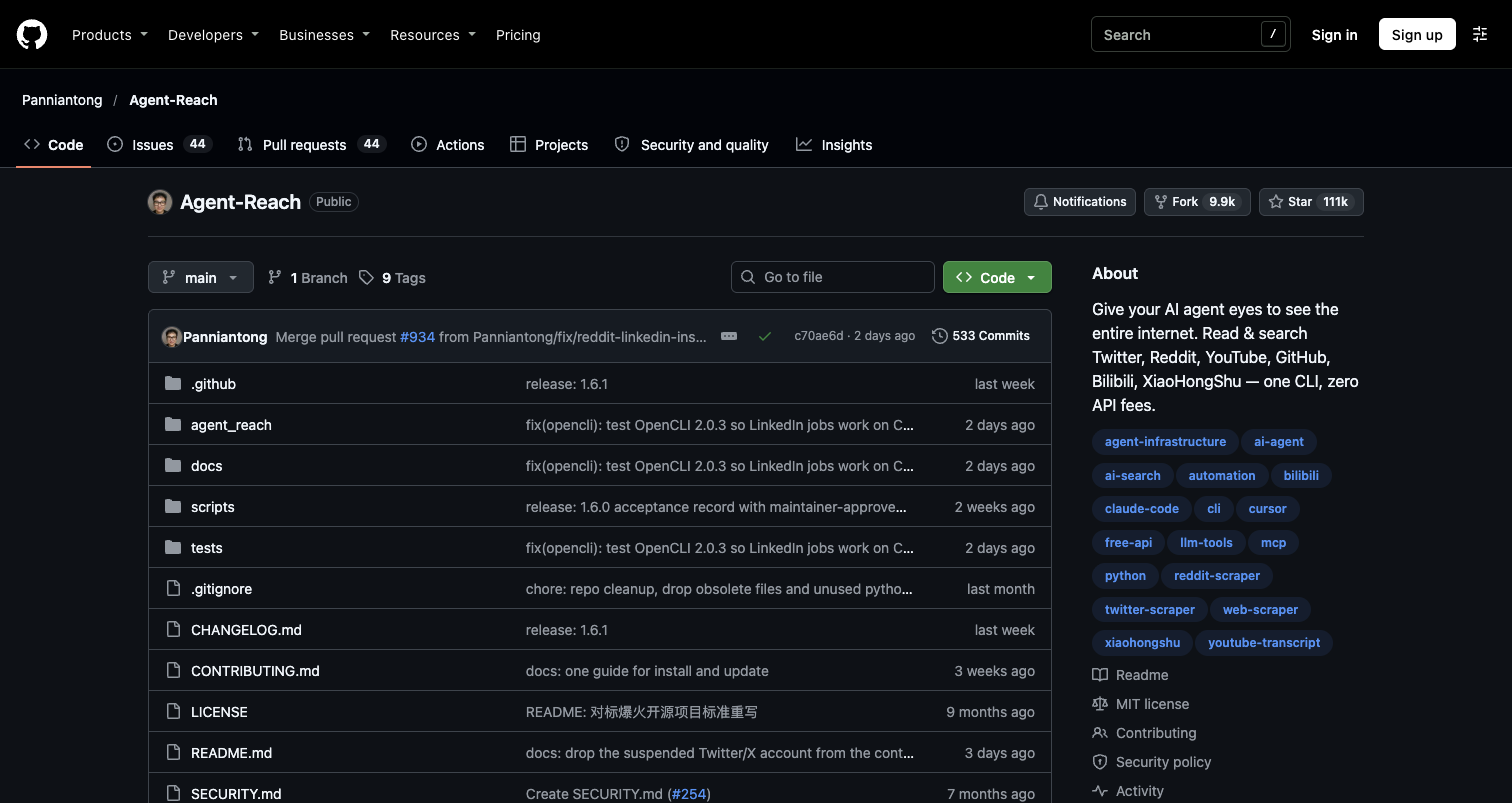
图:github.com/Panniantong/Agent-Reach 仓库页面(README 顶部标语"让 AI Agent 够得着它自己上不去的互联网"),截取日期:2026-11-10。
渠道分三档:默认、可选、实验
README 里有一张渠道表,把支持的平台按"装好就能用 / 说一句就开启 / 能用但可能随时失效"分成三档。
默认档包括 bilibili(搜索、视频信息、热门、字幕)、v2ex(热门、节点、帖子和回复、用户)、github(搜仓库、读仓库/README、读 issue 和 PR 含评论)、youtube(视频信息、搜索、字幕、语音转文字)、web(网页搜索、网页阅读,作为保底)。其中 bilibili 字幕需要登录扫码,youtube 转文字需要 Groq 或 OpenAI Key。
可选档包括 xiaohongshu(搜笔记、读正文、看评论)、xueqiu(实时行情、搜股票、热帖、热股)、boss(搜职位和 JD)、xiaoyuzhou(播客转文字)、linkedin(搜职位、读职位详情)、reddit(搜帖子、读正文、看评论、看版块)。这一档说一句"帮我加上 XX"就开启,需要的软件会自动装好。
实验档是 twitter、facebook、instagram,README 的说明是"能用,但平台反爬更严,可能随时失效"。
这个分档本身就是一个有用的信号:它把"平台反爬强度"显式地告诉了你。默认档是反爬宽松、能稳定用的;实验档是反爬严、随时可能失效的。对一个要长期跑的 agent 工作流来说,知道哪些渠道"可能随时失效"比知道"它支持多少平台"更重要。
登录态怎么处理:专用浏览器 + 复制一份会话
要登录的平台,Agent Reach 用的是它自己的专用浏览器,在后台运行、不弹窗。README 里对这一点的描述值得逐字读:第一次用某个网站时,会把你 Chrome 里这个网站的登录复制一份过去,原浏览器不变,不读密码库。复制过来的通常是主账号,建议换成小号。
这个设计解决了 agent 读登录态平台的一个真实矛盾:agent 需要登录态才能读内容,但你又不想把自己的主账号、密码库直接交给它。Agent Reach 的折中是"复制一份会话、用专用浏览器、不碰密码库",并且明确建议你用小号。
但这里有一个边界要说清楚:复制过来的会话本身就是登录凭证,它存在 Agent Reach 的专用浏览器里。README 建议换成小号,这个建议是对的——如果某个渠道的会话被滥用,损失被限制在小号范围内。对要长期跑、要读敏感内容(比如自己的小红书账号、自己的雪球持仓)的人来说,这一步不是可选项。
安装方式:一句话交给 Agent
README 给的快速上手是把一句话发给你的 Agent:“帮我安装 Agent Reach:https://raw.githubusercontent.com/Panniantong/Agent-Reach/main/docs/install.md”。安装和升级都是这一条命令,剩下的由 Agent 自己完成。
过程中你可能被问到两件事:允许它执行命令(如果 Agent 说自己不能运行命令,去它的设置里打开"允许执行命令");装 uv(一个安装命令行程序的小工具,不需要管理员密码,电脑上没有的话 Agent 会先装它)。
这种"把安装文档的 URL 交给 Agent、让 Agent 自己装"的方式,是现在开源 agent 工具的常见做法。它的好处是省事;需要注意的是,你实际上是在授权 Agent 去读一份远程文档并按文档执行命令——文档内容变了,行为就变了。对这类工具,值得养成一个习惯:装之前先看一眼那份 install 文档里到底让它执行了什么。
它和"通用搜索"的差别在哪
Agent Reach 解决的不是"能不能搜到",而是"能不能拿到干净的结构化数据"。README 里举的例子:雪球行情、V2EX 帖子和回复、GitHub 仓库和 issue,拿到的是整理好的内容,而不是让 agent 去解析一个反爬页面。
对 agent 工作流来说,“拿到结构化数据"和"拿到一堆 HTML 让模型自己解析"是两种完全不同的成本和可靠性。前者把解析工作前置到了工具层,后者把解析压力留给了模型,还容易因为页面结构变化而失败。Agent Reach 的价值主要在前者。
边界与局限
需要说清楚几点。第一,渠道表是"当前版本的情况”,平台反爬策略在变,实验档的渠道可能随时失效,默认档也不保证永远稳定。第二,要登录的渠道依赖会话复制,会话本身是凭证,用小号是 README 自己的建议。第三,youtube 转文字、xiaoyuzhou 播客转文字需要额外的 Groq 或 OpenAI Key,不是零成本。第四,README 顶部有大段赞助商内容(Bright Data、RapidProxy、BrowserAct 等数据采集服务),这些是商业推广,和 Agent Reach 本身的功能是分开的,评估工具时不要把赞助商的能力算到它头上。
一句话总结
Agent Reach 是一个把"agent 够不着的登录态平台、视频内容、中文平台"打包成一条命令的开源 CLI,渠道按反爬强度分三档、登录态用专用浏览器加会话复制、安装交给 Agent 一句话完成。它解决的是 agent 工作流里"拿不到干净数据"这个具体问题,而不是通用搜索的替代品。
参考来源
- Agent Reach README(Panniantong/Agent-Reach,main 分支,2026-11-10 采集)https://github.com/Panniantong/Agent-Reach
(以上网页采集日期:2026-11-10。README 内容可能随版本更新变化,以原始页面为准。)