ARTICLE / ai
0.6B 也能克隆声音了:Audio8-TTS-Realistic 本地实测,和 Qwen3-TTS-1.7B 掰手腕
title: “0.6B 也能克隆声音了:Audio8-TTS-Realistic 本地实测,和 Qwen3-TTS-1.7B 掰手腕” date: “2026-10-30 12:00:00 +0800” weight: 3 tags: [TTS, 语音合成, 声音克隆, 本地部署, 开源模型] menu: main: parent: “AI工程化”
最近开源社区冒出一个很有意思的模型:Audio8-TTS-Realistic-0.6B。它是 Audio8-TTS-Preview-0.6B 的升级版,主打两件事——语音更真实、语言从 11 种扩到 23 种,而主模型参数量保持 0.6B 不变,权重总共只有 2.57GB,Apache 2.0 许可,可以商用。
小模型的卖点从来不是"最强",而是"够用的质量 + 便宜的部署"。官方榜单上它和 4.6B 的 Fish S2 Pro、4.7B 的 Higgs Audio v2 在 Seed-TTS 基准上打平手,这就有意思了:如果 0.6B 真的能摸到 4.6B 的水平,那本地跑声音克隆的门槛又被拉低了一截。
榜单是别人跑的,机器是自己的。我把这个模型拉到本地,和手里已经跑了几个月生产任务的 Qwen3-TTS-1.7B(MLX 量化版,日常负责一个自定义音色的配音产线)做了同条件对比:同一段 20 秒参考音频、同一份逐字转写、同样的三段测试文本,两边各合成一遍,看克隆相似度、音质、稳定性。这篇文章把过程、数据和踩坑都摊开讲。
这是个什么模型
Audio8-TTS-Realistic-0.6B 的架构叫 DualAR,思路来自 Fish Audio S2 Pro:一个"慢 AR"Transformer(24 层、宽度 896)每帧预测一个语义 token,一个"快 AR"Transformer(4 层)负责把这帧的 10 组声学 codebook 补全,最后由自带的神经 codec(44.1kHz 采样率)解码成波形。
几个关键规格:
| 组件 | 配置 |
|---|---|
| 主模型 | 601M 参数(不含 codec) |
| 慢 AR | 24 层 × 896 宽度,14 注意力头 / 2 KV 头 |
| 快 AR | 4 层 × 896 宽度 |
| 声学 token | 10 codebooks × 4096 条目 |
| Codec | 44.1kHz,每帧 2048 采样(约 21.5 帧/秒) |
| 上下文 | 2048 packed 文本/音频位置 |
| 权重体积 | 主模型 1.20GB + codec 1.35GB ≈ 2.57GB |
注意"0.6B"这个数字不含 codec——codec 单独占 1.35GB,比主模型还大。这不是文字游戏,但部署时要按 2.57GB 的实际体积算磁盘和内存。
语言覆盖上,Realistic 版在 Preview 的 11 种(中英日韩德法西意波荷粤)之外新增了阿拉伯语、印地语、俄语、葡语、泰语、越南语等 12 种。不过官方自己贴的分语言数据很诚实:新增语言里泰语词错率高达 48.6%、越南语 28.1%、芬兰语 32.3%,而中文普通话 CER 只有 1.1%、英语 WER 2.2%——中文和头部语言是强项,长尾语言是"支持"但不等于"能用"。
官方对标数据(各家口径不完全一致,仅供参考):
| 模型 | 参数 | Seed-TTS 中英错误率 | MiniMax 24语 |
|---|---|---|---|
| Audio8-TTS-Realistic | 0.6B | 1.25 | 5.89 |
| Qwen3-TTS-12Hz-0.6B | 0.6B | 1.12 | — |
| Qwen3-TTS-1.7B | 1.7B | 1.01 | 27.41 |
| Fish S2 Pro | 4.6B | 1.32 | 4.40 |
| Higgs Audio v2 | 4.7B | 1.17 | — |
| CosyVoice3 | 1.5B | 1.67 | — |
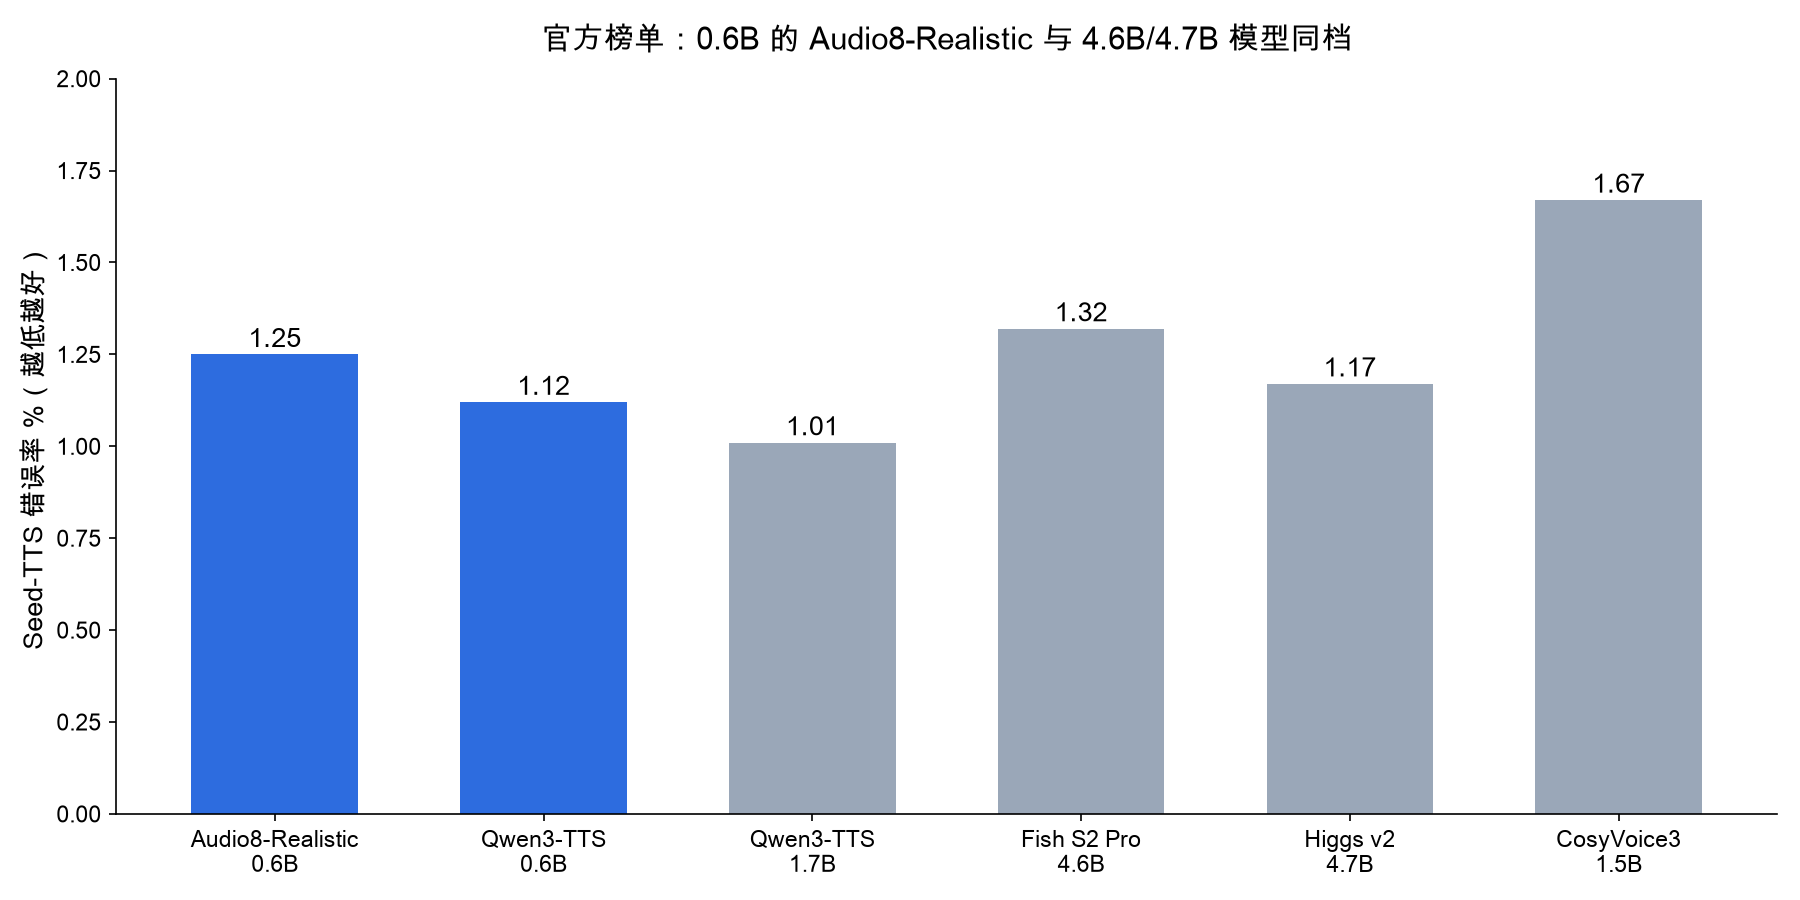
官方榜单错误率对比(越低越好):深色柱为 0.6B 级模型,Audio8-Realistic 与 4.6B/4.7B 模型落在同一区间(数据:各官方模型卡,口径不完全一致,仅供参考)
在 Seed-TTS 上它确实和 4.6B/4.7B 的模型一个档次。MiniMax 多语言平均它不如 Fish S2 Pro 和 Higgs v3,但比自家的 1.7B Qwen3-TTS 好不少。
实测怎么做的
对比对象是本地跑了很久生产任务的 Qwen3-TTS-1.7B(12Hz Base,8bit MLX 量化,配一个用 20 秒直播风格人声注册的自定义音色)。为了让对比公平,两边用完全相同的输入:
- 参考音频:同一段约 20 秒的连贯人声独白
- 参考转写:逐字匹配的文本(Audio8 要求转写与参考音频逐字一致,错一个字都会掉相似度)
- 测试文本三段:中文短句(指令播报风格,约 25 字)、中文长段(AI 内容生产话题,约 90 字)、英文短句(经典测试句)
Audio8 侧的推理代码就是官方 README 的标准写法:transformers 4.57.3 + torch 2.13,AutoModel 加 trust_remote_code=True 加载,MPS 设备 FP32 推理。整个权重目录拷下来即可,不需要注册任何服务。Qwen3-TTS 侧走的是已经稳定运行的 MLX 产线。
一个实测前就值得说的点:权重下载是第一道坎。Hugging Face 国内直连不稳,走镜像站拉 2.57GB 大约 10 分钟。另外这个仓库的文件结构有陷阱——README 里的 pip 依赖清单只列了运行库,仓库里的自定义代码文件(modeling/processing 等若干 .py)和 12MB 的 tokenizer.json 必须一起下齐,漏任何一个都会在加载时报错,而且报错信息(比如 tokenizer 报 NoneType has no attribute endswith)完全不会提示你缺了哪个文件。建议直接用 huggingface-cli download 整仓下载,别手工挑文件。
合成质量:三条样本逐段对比
三段文本两边都一次跑通,没有失败重试。客观指标先看数据:
| 指标 | Audio8-Realistic | Qwen3-TTS-1.7B |
|---|---|---|
| 采样率 | 44100 Hz | 24000 Hz |
| 中文短句时长 | 7.11s | 6.08s |
| 中文长段时长 | 19.37s | 16.00s |
| 英文短句时长 | 3.76s | 3.84s |
| 长文本尾部过零率 | 0.054(干净) | 0.077(正常) |
| 音量动态(RMS) | 0.066-0.079 | 0.054-0.067 |
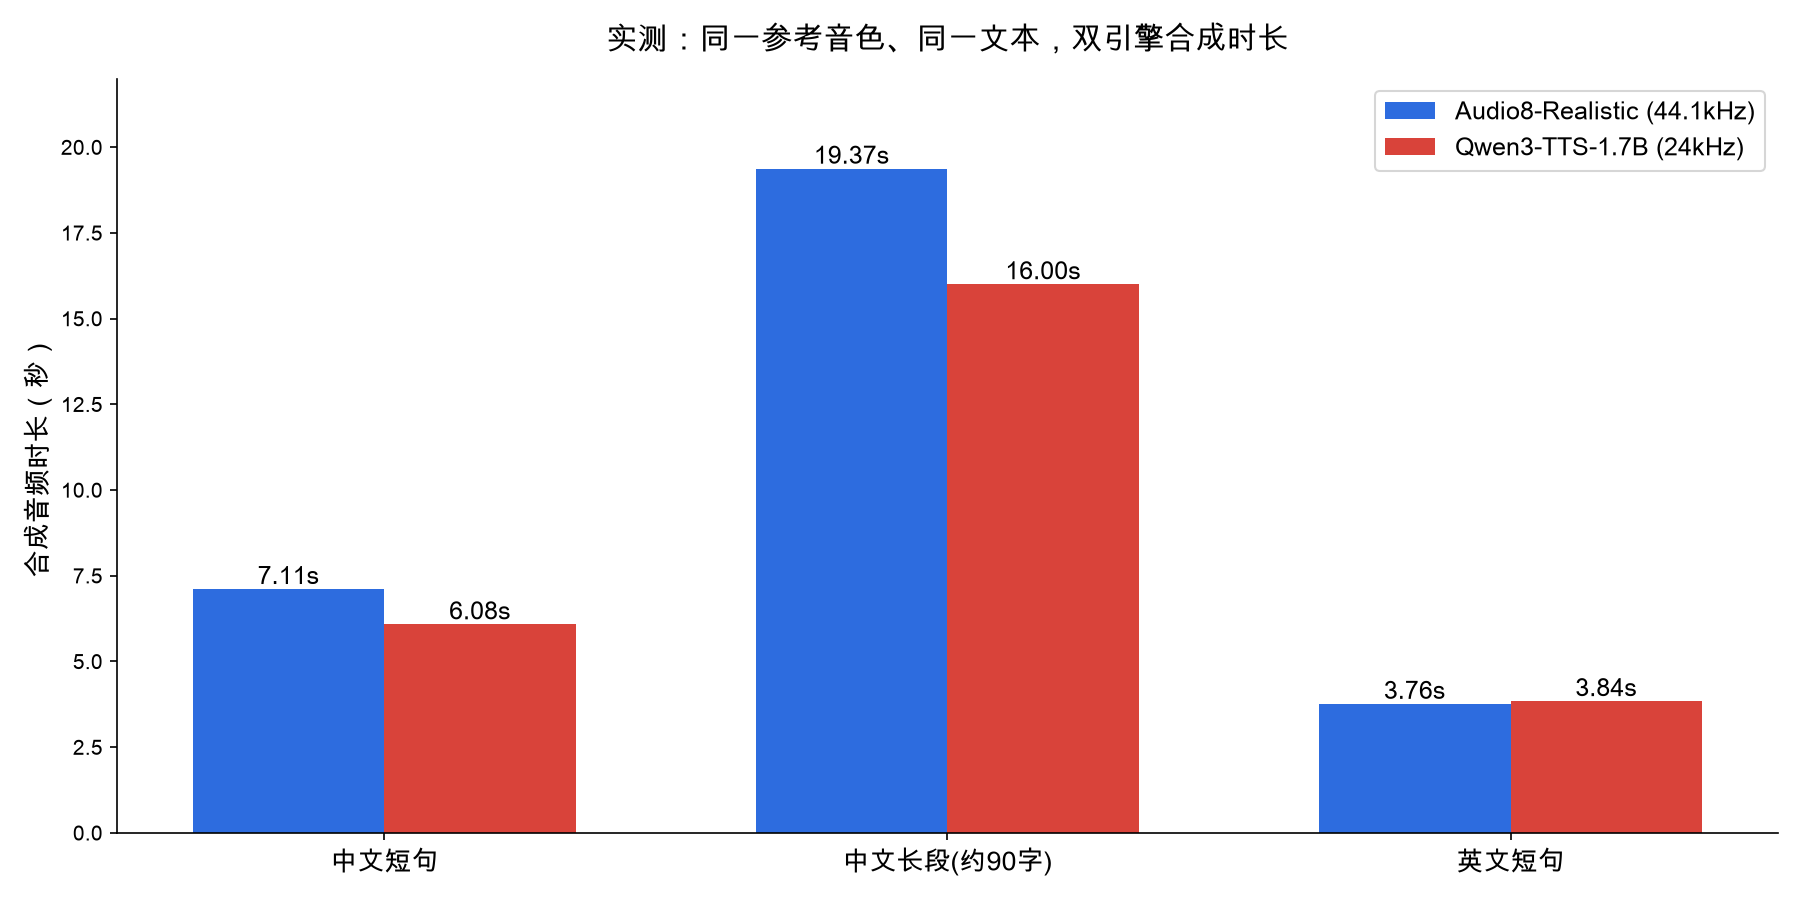
同一参考音色、同一文本下双引擎的合成时长:中文 Audio8 长 17%-21%,英文基本持平(本文实测数据)
几个值得展开的观察:
采样率差距是实打实的。 44.1kHz 对 24kHz,意味着 Audio8 的输出保留了更多高频细节,后期能做的处理空间更大——比如要进视频剪辑、要转 mp3 再压缩,高采样率源文件的耐压度明显更好。对做配音产线的人来说,这一项就值回票价。
长文本稳定性过关。 本次 FP32 路径跑 19 秒长文本,尾部过零率 0.054,和整体持平,没有出现尾部劣化。但注意这仅是 FP32 的实测结论——量化部署路径本文没有测试,长文本下的稳定性需要使用者自行验证。
语速略有差异,且方向随语言变化。 中文文本 Audio8 合成的时长比 Qwen3-TTS 长 17%-21%(中文长段 19.37s 对 16.00s,中文短句 7.11s 对 6.08s);英文短句反而基本持平甚至略短(3.76s 对 3.84s)。Audio8 的中文节奏更从容,但如果你的产线对时长有精确卡点(比如视频配音对帧),切换模型后需要重新校准,且中英文要分别校。
听感层面(这部分主观,供参考):官方对 Realistic 的定位是"显著提升语音真实感",Seed-TTS 说话人相似度从 0.682 提到 0.704,方向性结论有数据背书。本文只实测了 Realistic 对 Qwen3-TTS:两者都能抓住参考音色的基本特征,Audio8 的音色"厚度"更接近参考音频,英文发音明显更顺,Qwen3-TTS 的英文带一点翻译腔。注意本文没有跑 Preview 版做对照,Realistic 相对上一代的听感差异不在本次实测范围内。
速度:这笔账要算清楚
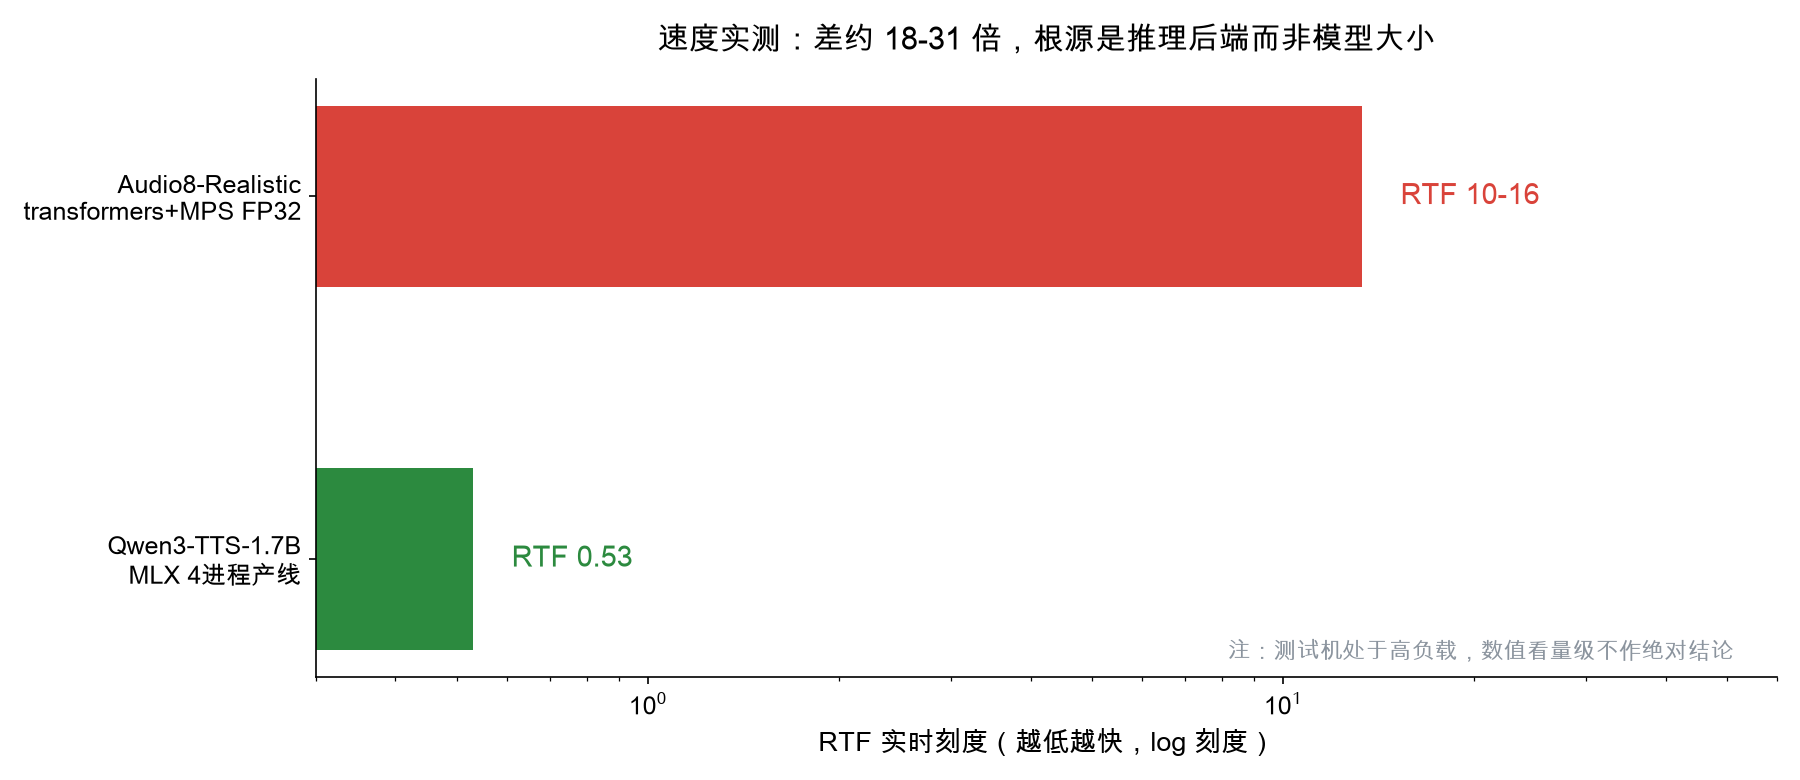
双引擎实时刻度(RTF)对比:Qwen3-TTS MLX 产线 0.53 对 Audio8 transformers+MPS 的 10-16,差约 18-31 倍(本文实测,高负载下取量级)
速度是这次实测里最纠结的部分,必须诚实地说清楚测试条件:测试时机器正被大量后台任务压着,系统负载一度超过 150,所以测出来的绝对速度严重失真,只能看量级。
在 MPS(Apple 统一内存 GPU)+ FP32 条件下,Audio8-Realistic 合成 7 秒中文音频耗时约 2 分钟,实时刻度(RTF)在 10-16 之间——远慢于实时。而 Qwen3-TTS-1.7B 的 MLX 产线在同机器的历史稳定数据是 RTF 0.53(4 进程并行,822 字 100 秒)。按实时刻度口径算,两条路线大约差 18-31 倍。
差距的根源不在模型大小(0.6B 反而更小),而在推理后端:Qwen3-TTS 有原生 MLX 后端,是 Apple Silicon 上的最优解;Audio8 目前只有 transformers(PyTorch)和 CUDA/SGLang 两条官方路径,前者在 Mac 上吃不到 MLX 级别的优化,后者需要 NVIDIA GPU。我还试了 MPS 上的 BF16 推理想提速,结果掉进了另一个坑:部分算子回退 CPU,速度不升反降,这条路目前走不通。
所以选型结论分两种场景:
- NVIDIA 显卡机器(云服务器、4090 工作站):Audio8-Realistic 挂 SGLang Omni 出 OpenAI 兼容接口,0.6B 的显存占用很小,配合动态批处理预计速度不会成为瓶颈——不过官方只验证了运行兼容性、未发布吞吐数据,上量前建议先自测
- Apple Silicon 纯本地:现阶段 Qwen3-TTS 的 MLX 路线仍是速度首选,Audio8 适合"不赶时间的高质量离线合成"(比如 overnight 批量生成),除非社区出了 MLX 移植
部署踩坑清单
把这次部署踩的坑列成速查表:
| 坑 | 现象 | 解法 |
|---|---|---|
| 仓库文件下不全 | 加载时报 tokenizer/建模错误,报错不指明缺哪个文件 | 整仓下载,别按 README 挑文件 |
| tokenizer.json 漏下 | NoneType has no attribute endswith | 它有 12MB,按大小过滤会漏掉 |
| HF 直连超时 | 下载挂死 | 走国内镜像站 |
| MPS + BF16 | 速度反常慢,CPU 占用低 | 用 FP32;BF16 路径等社区修 |
| 量化路径 | 本文未测,稳定性未验证 | 量化部署下长文本需自行验证,必要时切段 |
| 参考转写不匹配 | 克隆相似度下降、稳定性变差 | 转写逐字校对,参考音频要干净 |
| 上下文 2048 上限 | 参考音频+转写+目标文本超长会截断 | 长文分段合成再拼接 |
和上一代(Preview)比,值不值得升级
如果你已经在用 Preview 版:Realistic 的提升是实打实的——韵律自然度、多语言覆盖、克隆相似度(Seed-TTS SIM 0.682→0.704)都有进步,推理接口完全一致,换权重目录就能用,升级没有成本。
如果你在选型阶段:中文配音场景,它和 Qwen3-TTS-1.7B 各有胜场。Audio8 赢在采样率(44.1k)、英文质量、克隆灵活性(transformers 标准接口,零服务依赖)和许可(Apache 2.0 对商用更省心);Qwen3-TTS 赢在 Mac 上的推理速度和已有的产线生态。英 bilingual 或英文为主的场景,Audio8 优势更明显。
说下这个模型背后的信号:0.6B 的模型在文本智能上还只是玩具级,但在语音合成上已经摸到 4.6B 模型的 benchmark 水平——语音这个模态的"规模税"比文本低得多,端侧声音克隆在 2026 年已经是一台笔记本就能跑的事。对做内容、做产品的个人开发者来说,这可能是今年最实用的一条开源消息。
声音克隆在里面是怎么工作的
零样本克隆的原理值得单独讲清楚,因为它决定了你实际使用时的成败。合成时模型吃三样东西:参考音频、参考音频的逐字转写、目标文本。Slow AR 先把参考音频编码成语义 token 序列,和转写文本对齐后,模型就"知道"了这个声音在发每个音时的语义-声学对应关系;生成目标文本时,它沿用这种对应关系外推出新的 token 序列,codec 再解码成波形。
声音克隆的直观图景:参考音频的声学特征经模型映射到目标文本(概念示意图)
这套机制推出两条实用纪律。第一,转写必须逐字对:转写里错一个字,模型学到的是"这个音色把 X 发成 Y"的错误映射,目标文本里遇到相近音节就会翻车。参考音频如果从直播录像里剪,口播里的语气词(嗯、啊、那个)要么如实转写要么剪掉,不能"大概转一下"。第二,参考音频本身要干净:背景音乐、混响、多人说话都会污染音色特征,最好的参考是安静环境下的单人连贯独白,20 秒左右刚好——太短音色特征不够,太长浪费 2048 位置的上下文预算(上下文要同时装参考音频 token、转写和目标文本,长目标文本要靠分段解决)。
多语言的真实水平
官方分语言数据里藏着一些榜单平均数看不到的信息,摘几组关键值(CV3 与 MiniMax 两套测试集):
| 语言 | CV3 错误率 | MiniMax 错误率 | 判断 |
|---|---|---|---|
| 中文普通话 | 1.81 (CER) | 1.11 (CER) | 强 |
| 英语 | 2.91 | 2.16 | 强 |
| 日语 | 7.51 (CER) | 5.14 (CER) | 可用 |
| 德语 | 3.20 | 0.90 | 强 |
| 葡语 | 6.87 | 2.23 | 可用 |
| 粤语 | — | 31.35 (CER) | 弱 |
| 泰语 | 48.57 | 6.67 | 两套结果打架 |
| 越南语 | 28.11 | 7.97 | 偏弱 |
两套测试集结果差异大的语言(泰语 CV3 48.6% 对 MiniMax 6.7%)说明评估口径影响很大,选型时别只看一个榜。粤语在 MiniMax 一套上 31.35%,是全部评测语言里最差之一(CV3 未覆盖粤语)——如果你的目标受众是粤语用户,这个模型目前不适合,别被"支持 23 种语言"的宣传语带偏。
接进产线的两条路
真要用起来,有两条路径,成本和复杂度差很多。
轻量路径:transformers 直跑。 适合一次性任务、批量离线生成。加载模型后就是标准的 generate 调用,采样参数 temperature 0.8、top_p 0.95、top_k 50 是官方默认,输出用模型自带的 decode_audio 解码成 numpy 波形直接写 wav。这条路的坑前面都列过了,核心是文件下齐 + 长文本分段。
产线路径:SGLang Omni 服务。 官方提供了 SGLang Omni 适配器,装成独立插件不改动 SGLang 核心文件,暴露 OpenAI 兼容的 /v1/audio/speech 接口,支持 paged attention 和动态批处理——意味着你可以像调任何 TTS API 一样调它,多个任务自动排队批处理,还能在请求里带参考音频做克隆。这条路径需要 NVIDIA GPU,验证环境是 H20 BF16。对已经有 API 化配音产线的团队,这是正确的接入方式。
分段策略上有个细节:切段要在标点边界切(句号、问号、感叹号),不要硬切字数。每段 80 字以内比较稳,段间留 150 毫秒静音拼接,听感上是自然的句间停顿而不是机械断点。
听感对比:三个样本怎么听
本次实测的三组合成样本(中文短句、中文长段、英文短句,双引擎各一条,共 6 条)已作为随文音频提供,建议按下面的顺序对照着听,每条不到半分钟:
第一条对比:中文长段(最值得听)。 同样约 90 字的内容生产话题文本,Audio8-Realistic 合成 19.37 秒(44.1kHz),Qwen3-TTS 合成 16.00 秒(24kHz)。重点听三处:句间停顿的自然度——Audio8 的停顿更接近说话人的呼吸节奏;音色的"厚度"——Audio8 更贴近参考音频本来的质感;以及结尾收束是否干净——两条都没有虎头蛇尾。
第二条对比:中文短句。 25 字左右的指令播报风格,考察的是短句的爆发力和吐字清晰度。两条都清晰完整,差异主要在语速:Qwen3-TTS 的版本更急,Audio8 的版本更从容,各有适用场景。
第三条对比:英文短句。 经典测试句,考察非母语语音的自然度。这条差距最明显:Audio8 的英文发音顺滑接近母语者,Qwen3-TTS 带可感知的翻译腔。如果你做双语内容,这一条基本能替你做决定。
听的时候建议关注的坑:参考音频约 20 秒是直播风格人声,带口语化的语气;两个模型都忠实继承了这些特征——这恰恰说明零样本克隆在"复刻原味"上是称职的,也提醒你参考音频本身必须干净、风格要符合目标用途。
讨论与局限
这次实测没覆盖、但对选型有影响的一点值得单独说:本文的主观听感只有定性结论——“音色更厚"“英文更顺"是对比两个模型后的相对描述,没有做 MOS 打分类的规范化主观评测;克隆相似度等客观 SIM 分数引用的是官方报告值,不是本文复测值。另外采样参数只用了官方默认(temperature 0.8 / top_p 0.95 / top_k 50),对韵律稳定性的影响没有做扫描,追求极致稳定性的场景值得自己做参数消融。量化路径未测、速度数据受负载失真这两点,前文对应章节已说明,不再重复展开。
给不同场景的选型建议
把全文收敛成三句话:
做中文配音内容、用 Apple Silicon、要快:留在 Qwen3-TTS 系产线。迁移成本清单:Audio8 需要重新校准中文语速(中文 +17%-21%)、接入 transformers 推理依赖(约 3GB Python 环境)、且当前无 MLX 后端。
做双语/英文内容、有 NVIDIA 显卡、要 API 化:Audio8-Realistic + SGLang 值得直接上产线试,44.1kHz 和克隆质量对得起部署成本,Apache 2.0 商用无忧;上量前先自测吞吐(官方未发布数据)。
做端侧/离线产品、磁盘内存敏感:2.57GB 的全套积是它最大的护城河,等社区补上 MLX 或 ONNX 稳定路径,这类小模型会是端侧语音的有力候选。
在线试听样本
以下为本次实测的原始合成文件,与上文"听感对比"章节一一对应,可在线播放:
中文长段(约 90 字)
Audio8-Realistic(44.1kHz)
Qwen3-TTS-1.7B(24kHz)
中文短句
Audio8-Realistic
Qwen3-TTS-1.7B
(英文短句样本较短,差异在发音自然度,建议配合听感章节文字对照收听。)
参考资源:模型权重在 Hugging Face 搜 “Audio8-TTS-Realistic-0.6b”(Apache 2.0);技术报告 arXiv:2610.14776;推理代码与 SGLang 部署指南见官方 GitHub 仓库 Audio8-AI/Audio8_TTS。声音克隆请确保获得本人授权,合成内容按平台要求披露。