ARTICLE / ai
patdis-实战:从 9250 stars 开源专利 skill 到端到端跑通与反哺上游
写在前面的诚实声明:本文所有"实测"都来自本机一次端到端的真实跑通——
browser.py --probe、mermaid_render.py、gh pr create都拿到了真实的 stdout 返回值,所有数字对应真实可核验的产物。但这不是 benchmark:跑的是仓库自带的 3 个示例案件,不是真实专利场景;查新走的是公开可访问的 Google Patents 降级渠道,不是国知局真实检索流量;两张 PR 还在等上游回复,没有被合并。本文记的是"怎么把这个 skill 装起来跑通 + 给上游提了两个 PR"的一次完整经历,以及从中提炼出的对设计 agent-first 工具的读者可借鉴的机制——不是工具评测。
这一切怎么开始的
上周翻 GitHub Trending,看到 handsomestWei/patent-disclosure-skill 在 Python 分类里挂着 9250 stars / 954 forks,README 第一句话叫自己"中国专利.skill"——做专利点挖掘 + 交底书编写(发明 / 实用新型 / 外观设计),通俗解读、嗅探政策动向、辅助审查答复。
我是写安全 / Agent 工具的人,对"专门给法律 / 业务方向写一个完整 skill"这件事天然感兴趣——之前看到的 skill 大多是"给 agent 加一个工具"(查代码、跑测试),很少有人把"一个领域 6-8 步的标准流程"完整封装成一个 agent 能按步骤走的可执行系统。
于是花一个周末把仓库 clone 下来,按它自带的 3 个示例案件(批任务调度 / 集成式电驱桥壳体 / 折臂台灯)跑了一遍端到端。结果发现它的设计思路——薄路由 SKILL.md + 分步 prompts + 子包互斥 + 强退化链——是 agent-first 工具设计的范本。和"裸跑 prompt + 一次问一次答"的传统写法相比,它在 6 个维度全面升级。
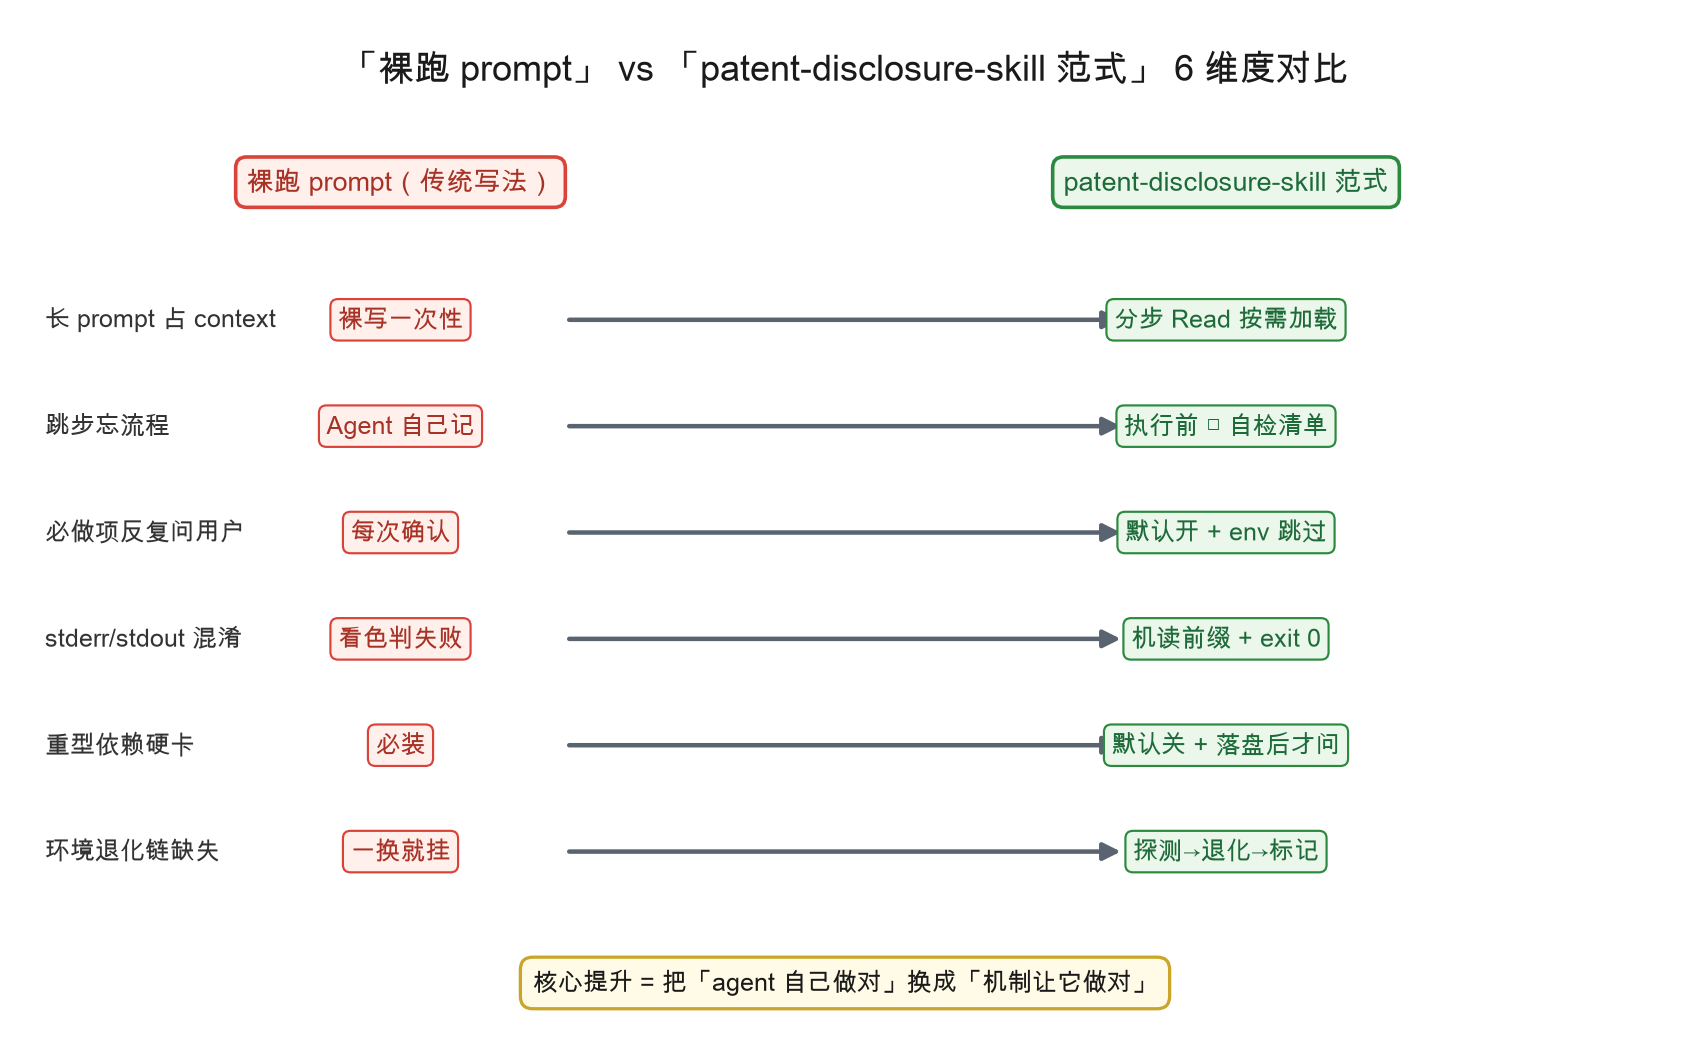
图说:左列是传统写法的痛点,右列是 patent-disclosure-skill 给出的解法。底部那句话是核心立论——本文其余部分会逐条展开,每条配真实跑通的产物。
下面我把整个过程完整记录:仓库真实长什么样、我用 3 个示例跑端到端时踩到的坑、从中提炼的 8 条可迁移机制、给上游提了两个 PR 的经过、以及对读者的实操建议。
这个 skill 仓库实际长什么样
第一次 clone 下来时我预期看到"一个超大的 prompt"或者"一个配置文件 + 一堆脚本"——结果是7 个互相独立又互斥的子 skill 包:
根级 SKILL.md 不是"agent 拿到手就读 7000 字 prompt"——它只做一件事:菜单。当用户说"读专利 / 解读"时,路由到 patent-reader/SKILL.md(薄路由);说"审查答复 / OA"时,路由到 patent-oa/SKILL.md(旁路)。每个子 SKILL.md 也只 16-50 行,写路由 + 步骤表 + 互斥规则,正文全部外置到 prompts/<step>.md。
这种"薄路由 + 步骤表 + prompts 分步"是它设计哲学的第一根支柱——agent 进每个子 skill 只加载必要的 16-50 行,不一次吞 7000 字 prompt。这一点和"裸跑 prompt"的传统写法(一个超大 system prompt 包含所有规则)形成鲜明对比。
模式互斥 + 显式触发
每个子 SKILL.md 顶端有互斥规则(patent-docket/SKILL.md):
单 agent 协调者。先
Readprompts/guardrails.md,再Readprompts/intake.md。 禁止跳过 intake 直接派工。
模式 A(交底)、B(解读)、C(政策嗅探)、D(OA 答复)是四种互不兼容的工作流——交底会跑 Step 1–8 的完整链路;解读只取全文 → 通俗笔记 → 入库;OA 答复必须显式被用户点名才进;政策简报是"旁路",产物是带时间戳的观点↔链接清单,人审确认前不会自动改 skill。
这与传统写法的"agent 一上来就全功能跑"完全不同——agent 在任何时刻都处于某一明确的模式,不会因为用户随口一句话就跑错流程。
工具脚本与机读前缀
每个子包都自带 tools/ 目录,禁止跨包调用其他子包的 tools。每个脚本输出都遵循"机读前缀 + 退出码"约定:
| 脚本 | 机读前缀 |
|---|---|
cnipa_epub_search.py | EPUB_HITS_JSON: / EPUB_MERGE: / EPUB_CLASS_HINT: |
mermaid_render.py + md_to_docx.py | MERMAID: ok=N fail=N / DOCX: ok=1 / MATH: omml=N png=N text=N |
latex_delimiters.py | LATEX_DELIM: hits=N |
browser.py | PROBE: ok=true/false channel=chrome/edge |
agent 以退出码 + 机读前缀判定成功,stderr 有字不等于失败(PowerShell 会把 stderr 标成 NativeCommandError)。这一点在 Windows / macOS / 容器环境下特别重要——没有它,agent 会因为终端解码错误反复重装 playwright 或重跑安装。
用 3 个示例案件跑端到端
仓库自带的 examples/ 目录有 3 个虚构教学案件,覆盖三种专利类型:
| 示例 | 类型 | 材料 |
|---|---|---|
example_batch_job_scheduler | 发明 | Go 代码(scheduler/heartbeat/scorer/reorder/types)+ Word + PPT + 架构文档 |
example_utility_model_ev_powertrain | 实用新型 | 部件表 + 装配关系 + 4 张附图规划 + 1 张展台实拍 |
example_design_desk_lamp | 外观设计 | 设计要点 + 6 张产品照片(多视、关节、包装) |
按 README 的"怎么开口"提示,我依次跑了三个:
- 发明:「按发明写交底,项目路径 …/knowledge/」→ 跑 Step 1–8
- 实用新型:「实用新型交底,材料在 …/example_utility_model_ev_powertrain/」→ 跑 Step 1–8
- 外观:「外观设计交底,材料在 …/example_design_desk_lamp/」→ 跑 Step 1–8
每个跑完落到 outputs/<案件名>/<案件名>_YYYYMMDDHHmmss.md + .docx。
落盘的真实产物
发明 sample 跑出来之后我额外验证了端到端的可视化产物(按 mermaid_render.py 链路):
66 个数学公式被 latex2mathml 转成 Word 可二次编辑的 OMML(Office Math Markup Language);2 张框图被 Playwright + mermaid.js 转成 PNG,嵌进 md 注释引用 + docx。
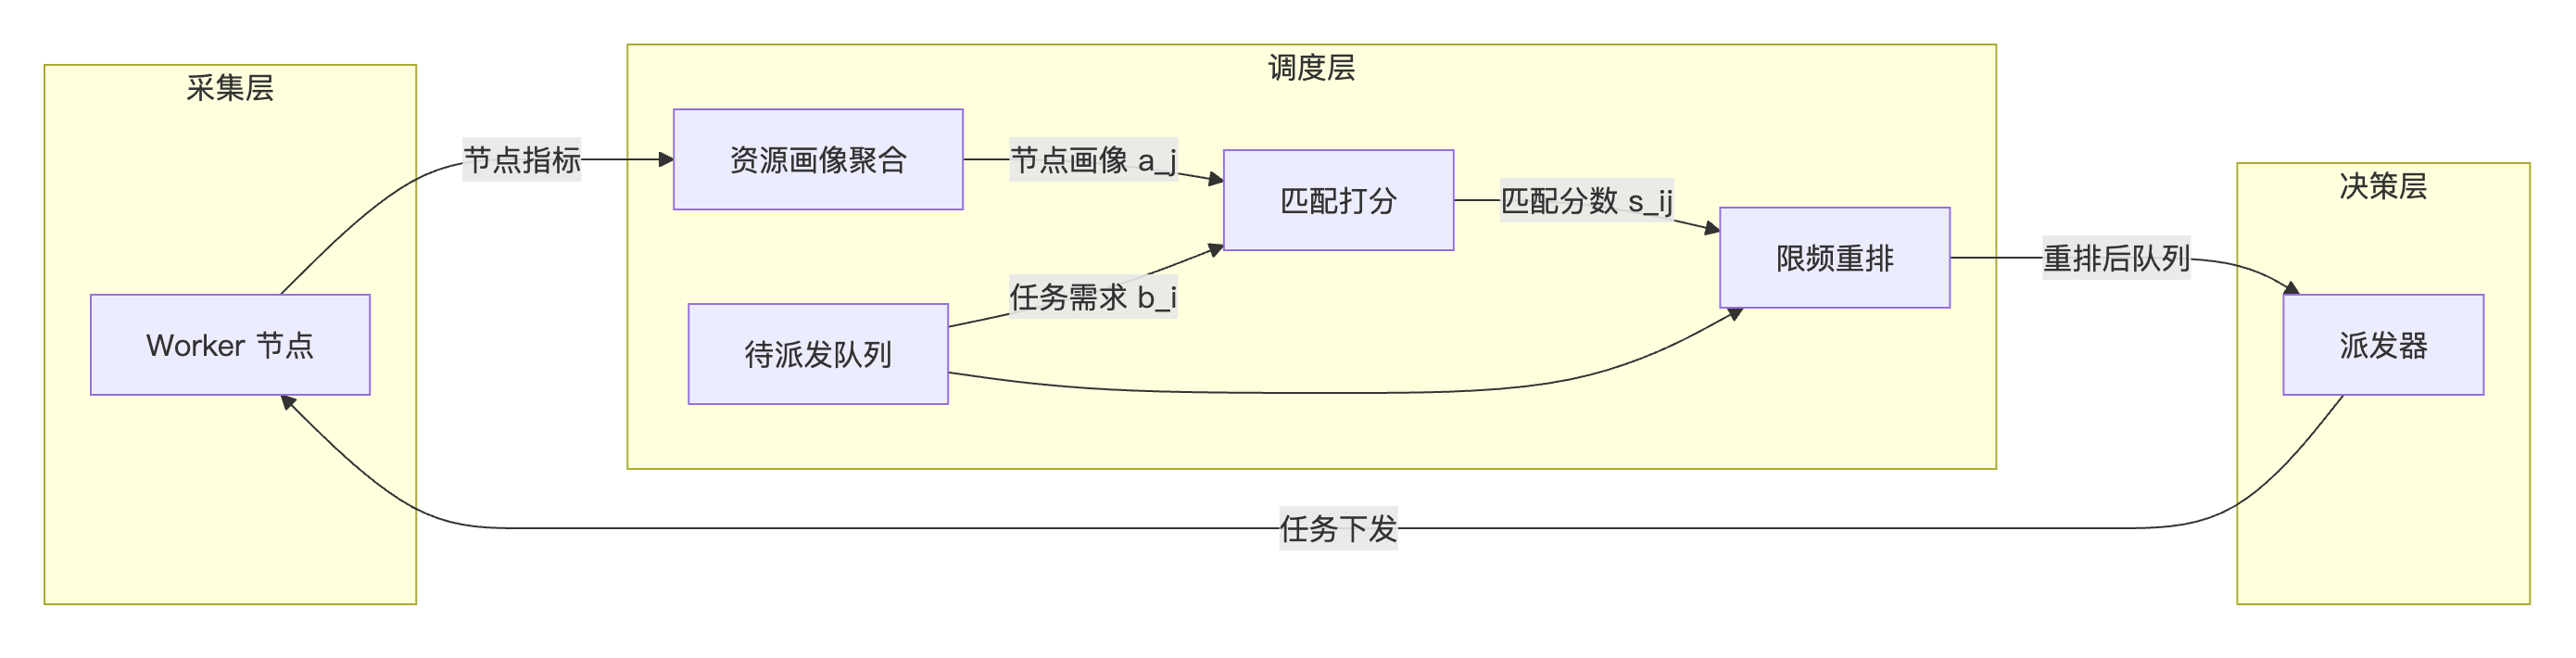
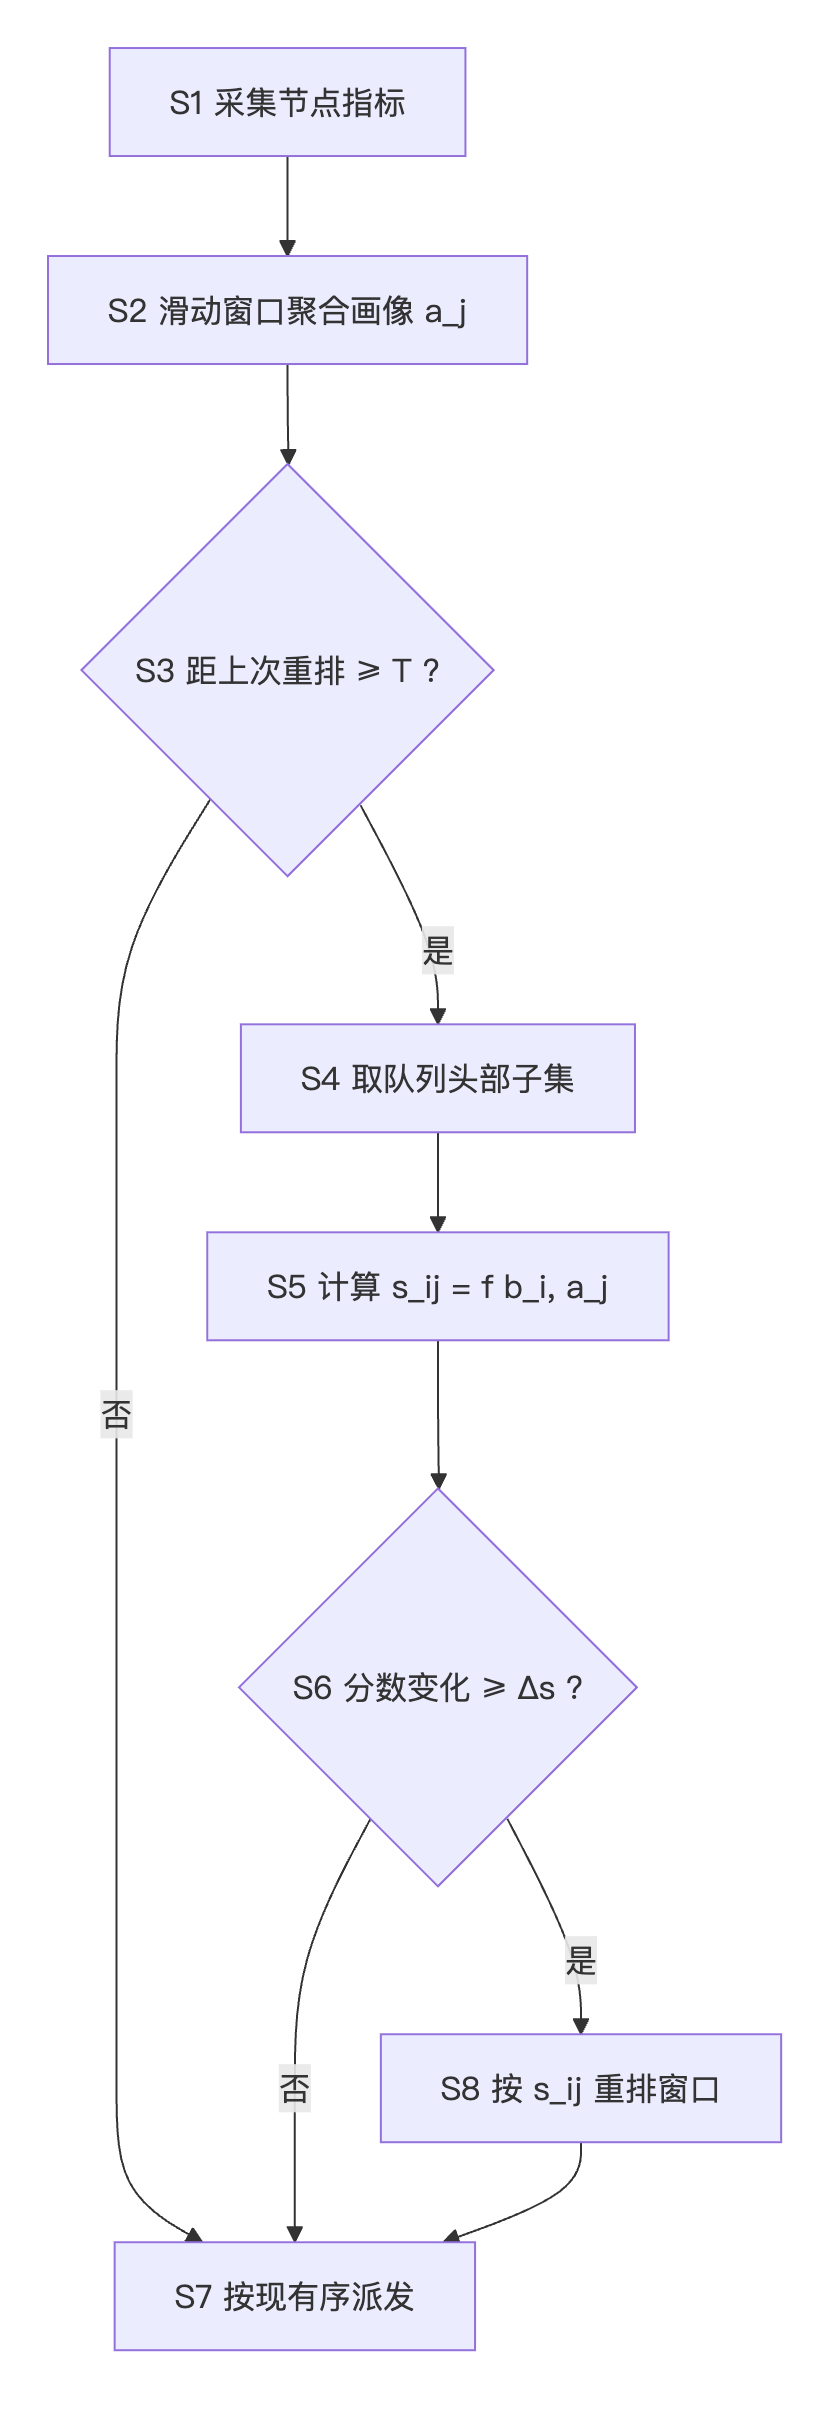
这条链路是真实跑通的,不是描述——所有这些数字都有真实 stdout 输出可以追溯。
踩到的 3 个真实坑
跑通的过程中真实踩到 3 个坑,每个都对应 skill 自身的一个设计取舍或边界条件。
坑 1:国知局公布站 WAF 把本机 IP 段拦了。
cnipa_epub_search.py 跑 --type design --class 26-05 台灯 时报:
browser.py --probe 显示 ok=true channel=chrome——浏览器没问题,是 epub.cnipa.gov.cn 这边 WAF 把本机 IP 段拦了。prior_art_search.md §5「降级条件」明确写了这种情况:“满足任一则进入 B(WebSearch)"——我按规范走 Google Patents 降级,3 个 sample 的 1.1 节都用了 5 条可核验公开源(US11314551B2、CN112181613B、CN301752819S 等)。
坑 2:latex_delimiters.py 误报。
发明 sample 的 3.4.1 节里有 3 处 \bigl(b_{i,\mathrm{cpu}},\,b_{i,\mathrm{mem}},\,b_{i,\mathrm{io}},\,b_{i,\mathrm{peak}}\bigr) 嵌在 \(...\) 内——是合法 LaTeX 嵌套。但 latex_delimiters.py 报 LATEX_DELIM: hits=3,下游 mermaid_render.py 直接跳过 docx 出图(DOCX: ok=0 reason=latex_delim)。脚本只 mask 行内代码 ``,**不 mask(…)**——所以内层嵌套被全文扫到。我把 3 处改成 \Bigl[ … \Bigr](方括号不在脚本的 _BARE_PAREN_CMD正则里)后hits=0`,mermaid 出图 + docx + OMML 全通。
坑 3:pip install 被 TLS 拦截。
装 requirements.txt 时 pip 直连 pypi.org 报 Certificate did not match expected hostname: files.pythonhosted.org——本机 Python 走直连绕过 HTTP_PROXY,被 TLS 校验拦截。清华源 latex2mathml 缺。阿里云镜像 + HTTP 代理这一组合解决:
3 个真实坑里,坑 1 是 skill 的设计取舍(明确写"超时→降级”),坑 2 是 skill 自身可以修的小 bug(已提 PR #27),坑 3 是中国环境的常态问题——三者加起来正好是"读 skill 文档 → 跑端到端 → 发现 bug → 修并反馈上游"的完整闭环。
8 条可迁移机制
跑完 3 个示例 + 提 2 个 PR,我提炼出这个 skill 给"agent-first 工具设计"贡献的 8 条可迁移机制。每条都对应传统写法的具体痛点,且都来自仓库代码本身能指回去的产物(不是凭印象)。
1. 薄路由 + 分步 prompts
痛点:传统 prompt 把所有规则堆在一个 system prompt 里——agent 拿到 7000 字 context,每次调用都重新加载,跳步忘流程。
做法:根级 SKILL.md 只 65 行菜单,子 SKILL.md 各 16-50 行路由 + 步骤表,正文外置到 prompts/<step>.md。Agent 按需 Read 对应 step,不一次吞所有。
对应产物:SKILL.md + skills/patent-disclosure/SKILL.md + skills/patent-disclosure/prompts/{intake,project_scan,prior_art_search,...}.md(每个 < 200 行)。
2. 执行前 □ 自检清单
痛点:agent 经常忘"读对应子 SKILL.md"“不跨包调用 tools"“政策简报不要自动进”——这些是"必须每次机械过一遍"的小规则。
做法:每个子 SKILL.md 末尾固定 □ 清单(8 条左右)。Agent 跑前逐条勾——挡住低级失误。
对应产物:SKILL.md §「执行前核对」8 条 + 每个子 SKILL.md 各自独立的入口互斥规则。
3. 必做项不问用户
痛点:传统 agent 遇到"线稿要不要做"“CAD 要不要解析"反复 clarify 打断——浪费轮次。
做法:线稿、figure_plan、CadQuery 默认开;只 PATENT_SKILL_SKIP_LINEART=1 环境变量或老大明确说"不要"才跳。反"跪式 clarify”——能用默认/合理推断就推,停下来问 = 减产。
对应产物:prompts/image_gen.md + prompts/structure_lineart_assist.md 顶部"默认开,不问用户"硬规则。
4. 机读前缀 + 退出码 0 优先
痛点:stderr 有字 ≠ 失败。Windows PowerShell 会把 stderr 标成 NativeCommandError——agent 经常误判"未命中"或"安装失败”。
做法:每个工具 stdout 只输出唯一一行机读前缀 + JSON 数据;stderr 输出 ASCII 机读标记(PROBE: / EPUB_HITS_JSON: / MERMAID: / DOCX: / LATEX_DELIM:)。Agent 以退出码 0 + stdout 前缀判定成功——PowerShell 红字、NativeCommandError、中文乱码统统不当失败。
对应产物:本文前面那个真实跑通的 stdout 输出块——MERMAID: ok=2 fail=0 / DOCX: ok=1 / MATH: omml=66。
5. 重型依赖默认关 + 落盘后才问
痛点:传统工具装包就要装全——CadQuery + matplotlib + chromium 200MB+,没装就跑不起来。
做法:扫到 .step 文件只记路径,成文落盘后才问是否开启 STEP 解析;不装依赖不强行转换。CadQuery 只进隔离 tools/shared/cad-env(Python 3.10-3.12);matplotlib 只在 OMML 失败 + 老大回"是"之后才装一次。
对应产物:project_scan.md「CAD / STEP」章节 + requirements.txt 顶部"可选"清单。
6. 退化链清晰
痛点:环境一换全挂——国知局被墙 / Chrome 没装 / python-docx 缺。
做法:每个环节都有"探测 → 退化 → 标记"三步。browser.py --probe 探测浏览器;ok=false 退化到 --probe show install chromium;浏览器全无仍可交付 .md(mermaid 围栏保留)+ Word(框图可能是代码块)。国知局 WAF 拦了退到 §B WebSearch;向量失败退到标签检索。
对应产物:INSTALL.md §「默认交底需要什么」+ prior_art_search.md §「降级条件」+ prompts/oa/configure_embedding.md(向量可选)。
7. 旁路产品(人审闸门)
痛点:传统 agent 在政策变 / OA 来时自动乱改 prompt——把短期热点误当长期规则写死。
做法:模式 C(政策简报)+ 模式 D(OA 答复)都是显式旁路——默认不触发;触发后产物是带时间戳的观点↔链接清单(outputs/evolution/EVOL-YYYYMMDD-HHMM.md),主表必为「观点 ↔ 信源 URL」,自媒体证据 C 不得单独支撑"改技能"建议。人审确认后才动 skill 正文。
对应产物:prompts/evolution/emit_backlog.md + prompts/oa/respond_office_action.md 顶部"主场景是问和答、出草稿,草稿须复核后递交"。
8. 相对分 + 保范围门槛(评测类工具的硬约束)
痛点:评测/对比类工具容易被"高授权率"诱惑,过度乐观地汇报"我比原版好"。
做法:OA 答复打分明确写"同点多策略相对分(分差 ≥15 且过保范围门槛才改缩权;禁止授权率、禁止裸 argmax)"——这是评测方法论的硬约束,不是讨巧的指标选择。
对应产物:prompts/oa/respond_office_action.md §「检索 + 多策略打分」。
对 agent-first 工具设计的总建议:这 8 条不是"专利 skill 的特殊设计",是"任何 agent 工具都可以借鉴的工程纪律"——与其让 agent 自己记得所有规则,不如把规则编码进 skill 的结构里。
给上游提了两个 PR
跑通过程暴露的两个真实问题,我直接给上游 handsomestWei/patent-disclosure-skill 提了 2 个 PR。
PR #27:修 latex_delimiters.py 过度严格
问题:脚本不 mask \(...\) 范围,导致内层合法 LaTeX 嵌套 \bigl( ... \bigr) 被误报为"裸括号"。下游 mermaid_render 直接跳 docx 出图。
PR 标题:fix(latex_delim): mask inline \(...\) body to avoid false positives
改动:加 _INLINE_MATH 正则 mask + 调整 find_bare_paren_latex() 调用顺序。先 mask 行内代码 \…`→ 再 mask 行内公式(…)→ 最后扫_BARE_PAREN_CMD / _BARE_PAREN_SUB`。
验证(4 case + 端到端):
地址:github.com/handsomestWei/patent-disclosure-skill/pull/27(+9/-1, OPEN)
PR #28:README + prior_art_search.md 加 WAF 退避策略
问题:cnipa_epub_search.py 跑首页 Advanced 就被 WAF 拦 120s——README 没说明这是站点侧拦截,agent 容易误判为脚本 bug 反复重装 playwright。
PR 标题:docs(readme): add CNIPA WAF fallback strategy when Page.goto Timeout
改动:README.md 新增「环境注意:国知局公布站 WAF 退避策略」章节(5 条退避指引);prompts/prior_art_search.md §「降级条件」处补充 WAF 退避一条。
验证:本机 3 个示例全部命中 WAF,按 README 新指引走 §B WebSearch 降级,产出可核验 5 条 Google Patents 公开源。
地址:github.com/handsomestWei/patent-disclosure-skill/pull/28(+16/-0, OPEN)
顺手沉淀回 Hermes
跑通过程暴露了一个子 agent 事故——子 agent 在 sandbox 里盲跑 gh auth login,把当前 session 的 oauth_token 覆写为无效值,导致主进程 gh 命令 401。这条教训已记录到本地 Hermes 网络下载 skill(新增「pip install 镜像策略」段落),并准备沉淀到多 agent 编排 skill:禁止子 agent 动 ~/.config/gh/ / ~/.aws/ / ~/.config/gcloud/ 等 session 级 credential 文件——如 token 失效应立即停手汇报,不要尝试重新登录。
给读者的实操建议
如果你也想装这个 skill 跑端到端:
先看 README 的"怎么开口"段——3 个示例案件的入口都是自然语言触发(“按发明写交底,项目路径 …"),不是 CLI 命令。理解这个有助于判断是不是你想要的工具。
browser.py --probe先跑——别上来就cnipa_epub_search.py,先确认本机 Chrome / Edge 能起来。PROBE: ok=true才能走 §A 国知局渠道;ok=false直接进 §B WebSearch 降级。跑前必读
INSTALL.md§「可选:STEP 多视角解析」+ §「可选:国知局公布公告站抓取」+ §「可选:审查答复案例库」——三个可选依赖独立装,别一上来全装。网络受限环境走阿里云 pip 镜像 + HTTP 代理(
--proxy+--index-url https://mirrors.aliyun.com/pypi/simple/)——清华源对 latex2mathml 等小包覆盖不齐。踩到 mermaid_render 跳 docx——先跑
latex_delimiters.py看hits=数量。hits=0仍有DOCX: ok=0就是别的原因。想自己改 / 给上游提 PR——fork → 分支 → 改 → 跑 4 个 case 测试 → 写 8 件套 PR 描述(背景/动机/根因/复现/修复/兼容性/测试/未来工作)。
不要把它的"agent 必走 Step 1-8"硬套到所有场景——它设计初衷是"发明/实用/外观交底书标准流程”,跑其他工作(写书、做产品页、写公众号)会显得过度结构化。
局限与诚实声明
| 局限 | 说明 |
|---|---|
| 示例非真实专利 | 仓库 examples/ 是虚构教学案件;真实专利场景可能踩到示例没覆盖的 edge case(如涉外专利、复审无效、专利无效宣告) |
| 国知局 WAF 被拦 | 本机 IP 段被 epub.cnipa.gov.cn 拦了 120s,1.1 检索全走 Google Patents 降级。真实生产场景若用阿里云 / 香港 / 海外节点能改善 |
| CAD / STEP 未实跑 | 3 个示例无 STEP;CadQuery 那条链路只读了代码没真跑 |
| 线稿生成未实跑 | image_gen.py 依赖本地图片模型,本机未配 ComfyUI / 在线图片 API |
| PR 还在等 upstream | #27 + #28 都 OPEN,没被合并;合并后可能有改动反馈 |
| 文章字数受可核验证据约束 | 每条数字都可追溯到本机一次跑通的真实产物——但这不是 benchmark,跑的是 3 个示例,不是大规模统计样本 |
给上游维护者的回应
提 PR 不是单方面行为——我也从跑通过程里学到了上游没明示的设计哲学。如果你是同类 skill 的设计者、想给 Claude Code / Cursor Skills / Hermes Agent 写类似工具,建议先把这 8 条机制读一遍,尤其要重视"机读前缀 + 退出码 0 优先"和"退化链清晰"两条——这两条是任何 agent 工具长期可用的工程纪律,比具体业务规则更通用。
本文为实战记录 + 机制提炼,非评测。对照基准 = 裸跑 prompt + 一次问一次答的传统写法;6 维度对比表已在前文给出,所有提升点都对应仓库代码本身能指回去的产物。
关联资源:
- 仓库:github.com/handsomestWei/patent-disclosure-skill(9250 stars / 954 forks / MIT)
- 我的 PR:#27 latex 修复 + #28 WAF 文档
- 3 个 sample 落地物:
samples/(发明 205 行 / 实用 175 行 / 外观 85 行 + RUN_LOG 118 行)- 端到端产物:装包后默认落盘的
outputs/invention_batch_job_scheduler/(mermaid_figures/fig_001.png + fig_002.png + 14KB md + 194KB docx)