ARTICLE / ai
内置搜索把两个文件报成一个:Copilot CLI 的 grep 压缩在损坏证据
11 月 1 日,用户 aaroneng 在 github/copilot-cli 提交了 issue #5318:内置 rg 搜索工具在输出触发"压缩"(compaction)时,会返回错误的文件名和行号——不同文件的结果被并进同一个文件名之下,真实行号被挪进正文文本里。
报告针对的版本是 1.0.105,问题状态为开放。
这类缺陷的危险不在崩溃,而在它破坏的是 agent 用来定位代码的证据本身。搜索结果错了,后续每一步推理都建立在错的文件路径上,而且没有任何报错提示你这一点。
一个精心设计的对照实验
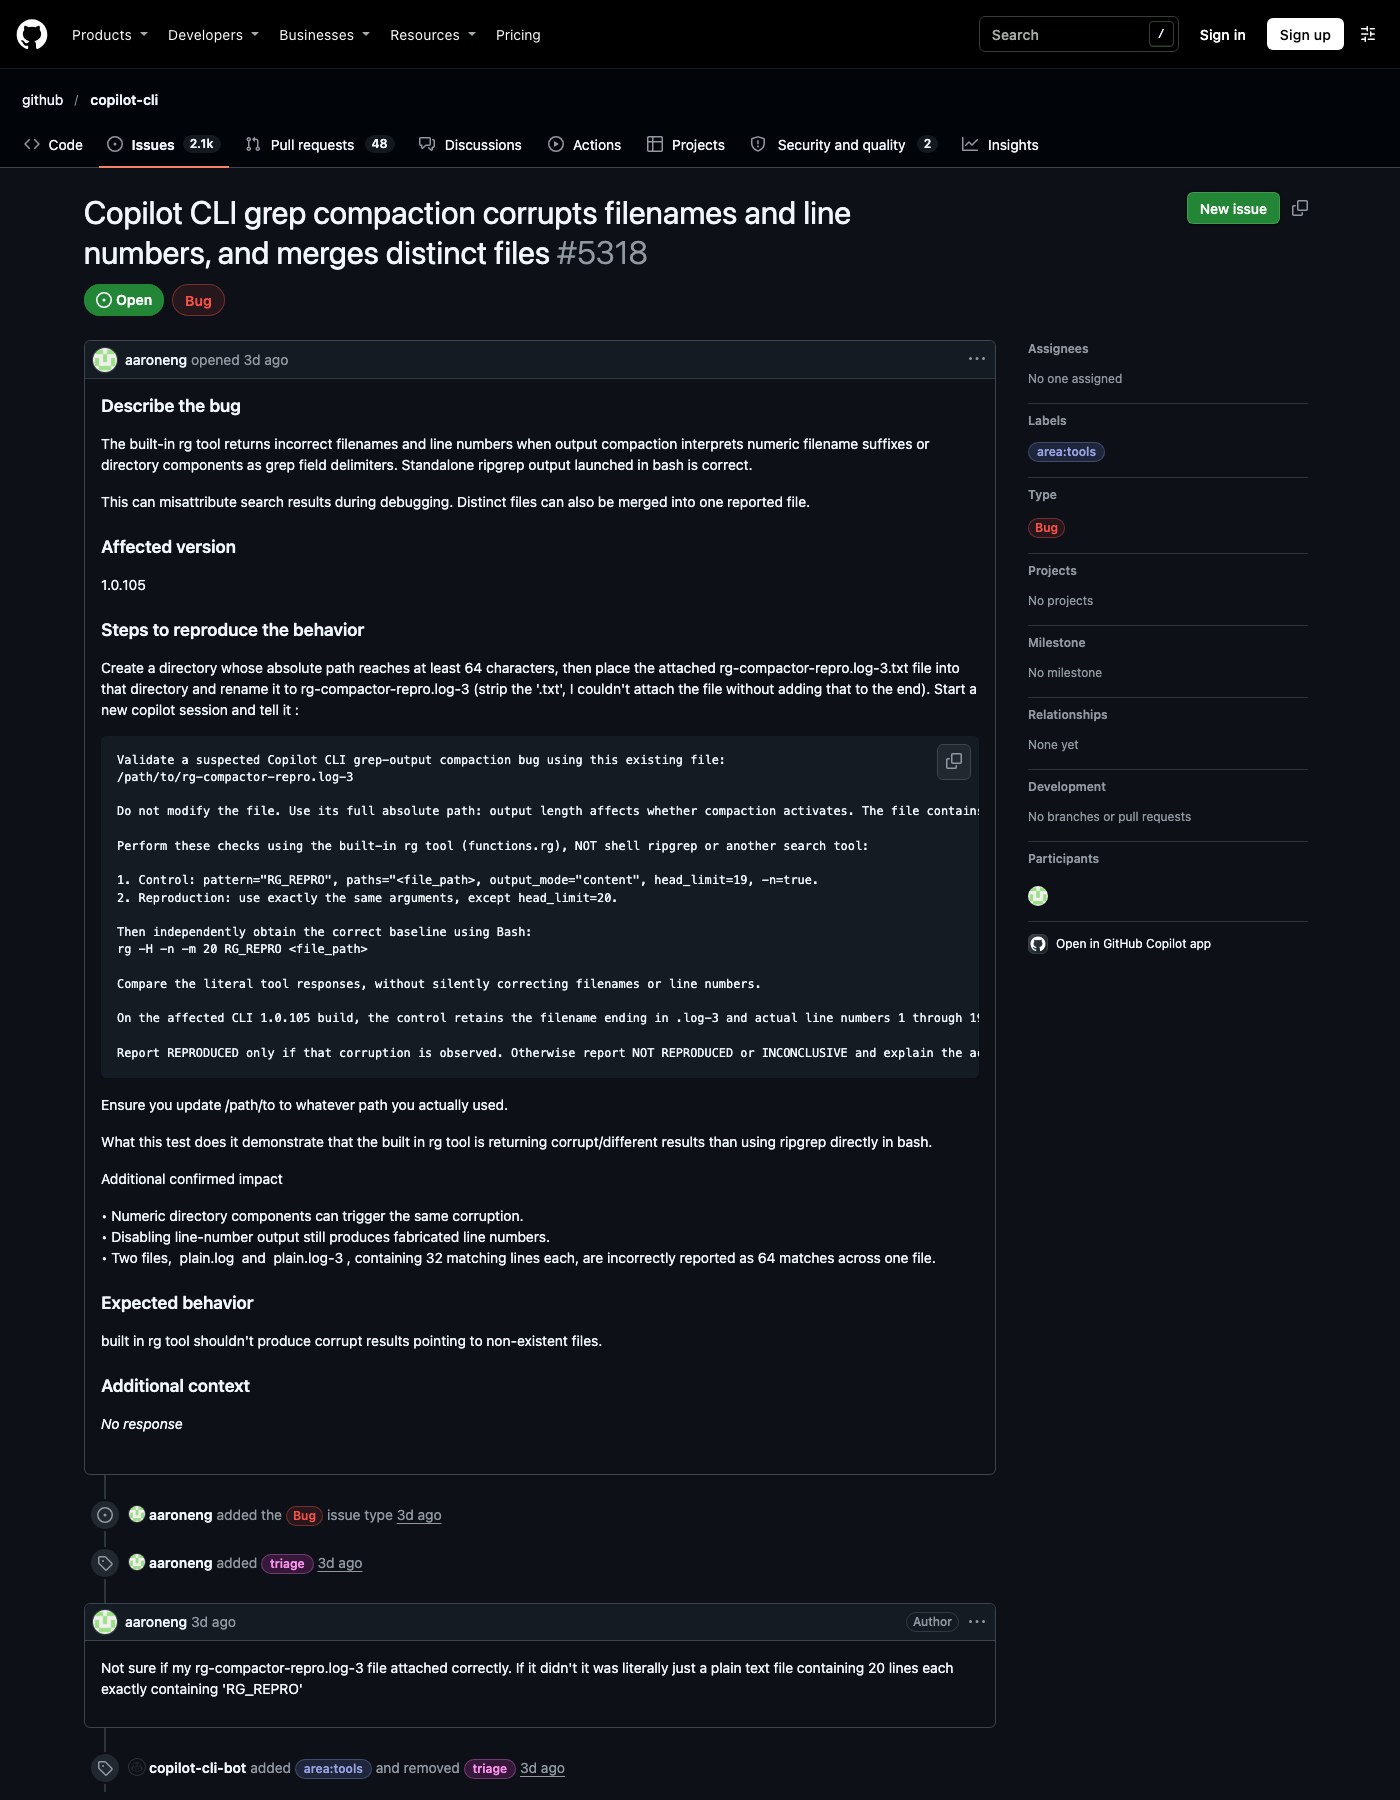
来源:github.com/github/copilot-cli issue #5318 页面截图,截取于 2026-11-05。
这份报告的特别之处在于,作者先把"怎么证明 bug 存在"的方法论写进了 issue。
他要求验证者用内置 rg 工具(functions.rg)而不是 shell 里的 ripgrep 做同一件事,然后拿两者对比。
具体构造是:在一个绝对路径至少 64 字符的目录里放一个名为 rg-compactor-repro.log-3 的文件,内含 20 行相同的 RG_REPRO 标记。对照组用 head_limit=19 请求内容模式加行号;复现组参数完全相同,只把 head_limit 改成 20。
输出长度是关键变量——恰好 20 行会触发压缩逻辑。在受影响的 1.0.105 版本上,对照组保留了 .log-3 后缀和真实的 1 到 19 行号;复现组则把所有结果归到 rg-compactor-repro.log 名下(丢了 -3),给每条结果显示行号 3,而把真实行号塞进文本,变成 "3: 1:RG_REPRO" 这样的形态。与此同时,bash 里直接跑 rg -H -n -m 20 RG_REPRO 的基线输出始终正确,保留 .log-3 和真实行号 1 到 20。
根因由此浮出:压缩器把文件名里的数字后缀(或目录名中的数字成分)误认成 grep 输出的字段分隔符,于是按位置重排了字段。报告还列出三条扩展影响:纯数字目录成分同样触发;关掉行号输出仍会凭空生成行号;两个各含 32 条匹配的文件(plain.log 和 plain.log-3)被错误合并报成"一个文件 64 条匹配"。
为什么这种 bug 比崩溃更难防
报告者在验证指令里专门写了一句:比较工具的原始响应,不要悄悄修正文件名或行号。这句话暴露了另一层风险——agent 往往会在"看起来合理"的方向上替工具圆谎。
如果模型拿着损坏的搜索结果继续干活,它可能自己就把 3: 1:RG_REPRO 读回成正常格式,于是整条链路上没有任何一处留下"曾经出错"的痕迹。对普通用户来说,症状是调试时被误导到不存在的文件和行;对管理 agent 流水线的人来说,这是更隐蔽的一类:工具输出与事实不一致,但输出结构完好、没有错误码,任何基于返回码的健康检查都会放行。
值得注意的还有这个 bug 的触发条件组合:长路径、数字后缀、输出刚好越过压缩阈值。三个条件单独看都无害,叠在一起才出错
——这解释了为什么它在日常测试里长期隐身,也解释了为什么报告者要用 head_limit 19/20 这种精确到一行的差分设计来钉住它。
排查自己的搜索链路时可以做什么
issue 目前仍是开放状态,标签只有 area:tools,还没有公开的修复记录。在此之前,使用 Copilot CLI 1.0.105 及相近版本的人可以对照几件事:需要精确定位时,让 agent 用 shell 里的独立 ripgrep 做一次基线比对;避免把带数字后缀的日志文件当作唯一证据源;审查会话记录时,重点看工具原始响应而不是模型的转述。
这些建议来自该 issue 报告的复现方法本身,适用范围限于报告描述的压缩场景。它的更大价值在于提醒所有做工具封装的人:对输出做任何"美化"或"压缩",都要先保证字段边界不被内容里的字符污染——grep 类工具的行号字段之所以可靠,靠的是分隔符约定,压缩器恰恰是在这个约定上翻了车。
参考来源
- github/copilot-cli issue #5318 原始页面(采集快照 2026-11-05):https://github.com/github/copilot-cli/issues/5318
本文面向授权安全研究与防御建设,未经授权对任何系统实施文中技术属违法行为。